Цель Достигнута: Как Следовать Инструкциям!
13.09.2024
Чтобы быть полезнее, роботы должны стать ленивее
13.09.2024Цель Достигнута: Как Следовать Инструкциям!
13.09.2024Чтобы быть полезнее, роботы должны стать ленивее
13.09.2024
Вы когда-нибудь задумывались, как обучают ваших любимых виртуальных ассистентов?
Добро пожаловать в удивительный мир обучения машин. Мы погрузимся в то, как виртуальные помощники, такие как GPT-4 или Claude-2, становятся умнее с каждым днем благодаря одной важной технике. Давайте разберемся, как это работает!
Знакомьтесь: Усиленное обучение с человеческим фидбеком (RLHF)
Некоторые из самых умных виртуальных ассистентов используют метод под названием Усиленное обучение с человеческим фидбеком (RLHF) для того, чтобы создавать ответы на ваши запросы, писать код и даже стихи.
Откуда у моделей берутся «хорошие» ответы?
Представьте, что вас просят выбрать лучший из двух ответов на один и тот же вопрос. Ваш выбор помогает модели понять, какой ответ лучше. Это и есть суть RLHF. Модель учится, сравнивая ответы и выясняя, какой из них более предпочтительный.
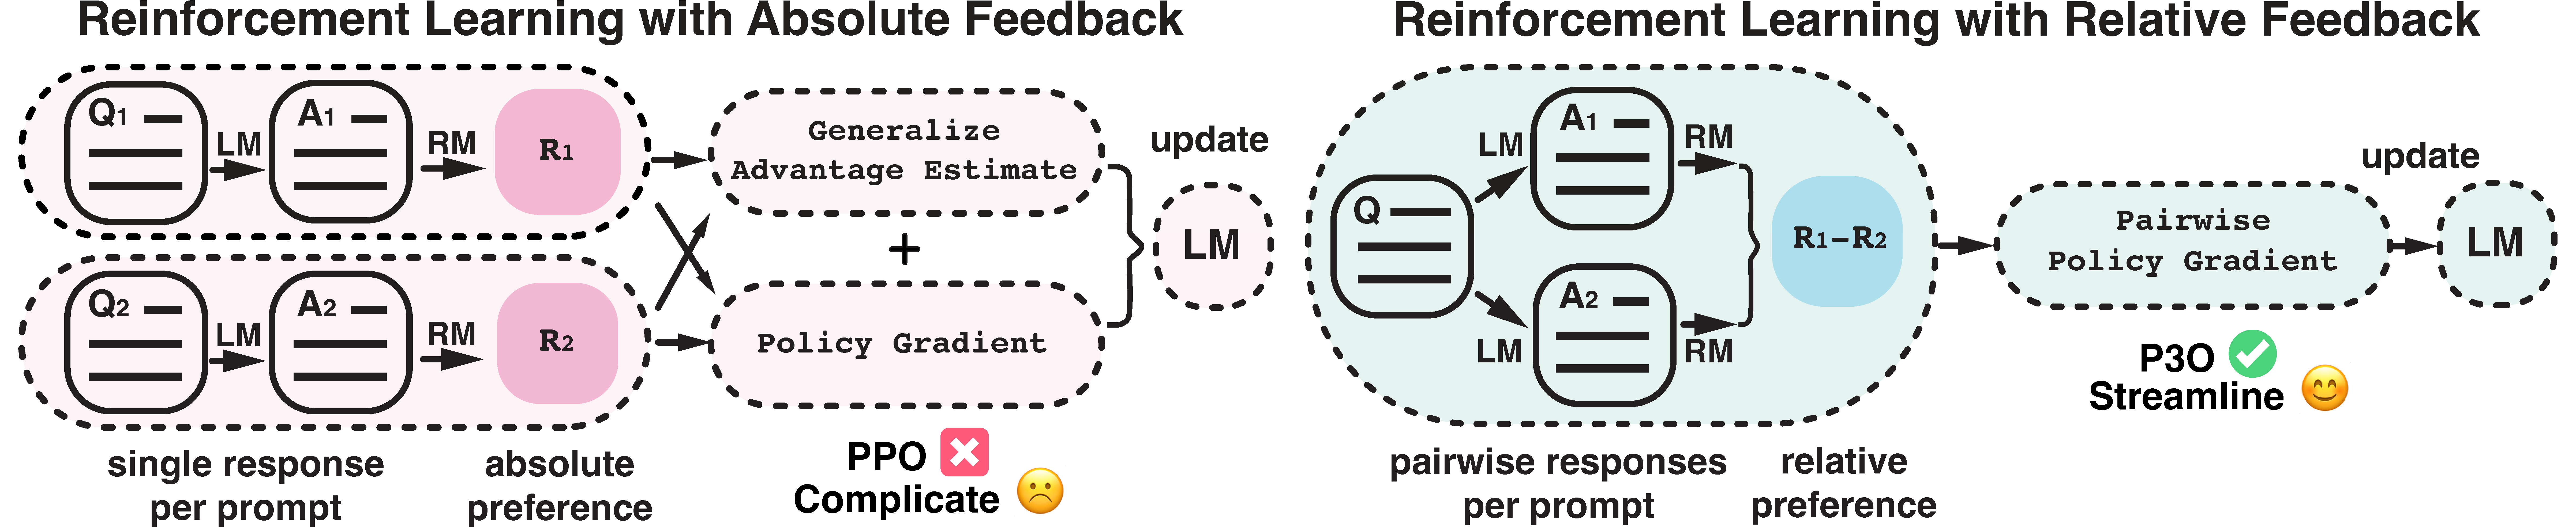
Рисунок: Диаграмма показывает разницу между обучением с использованием абсолютной обратной связи и относительной обратной связи.
Что такое PPO и почему это иногда не работает?
Для настройки этих моделей часто используют оптимизатор под названием Proximal Policy Optimization (PPO). Но у него есть свои проблемы: он может быть нестабилен и сложен в реализации. PPO работает на основе индивидуальных ответов, не сравнивая их, что иногда вызывает проблемы.
Есть ли решение? Знакомьтесь, P3O!
Чтобы улучшить обучение, был разработан новый метод — Pairwise Proximal Policy Optimization (P3O). Этот подход объединяет этап обучения с использованием сравнений и этап настройки модели, что делает процесс более гармоничным.
Этапы RLHF
Давайте быстро пройдемся по основным этапам RLHF:
- Этап супервизорного обучения (SFT): Модель обучается на высококачественном наборе данных, чтобы правильно отвечать на вопросы.
- Этап моделирования награды: Люди оценивают пары ответов, помогая модели понять, какой ответ лучше.
- Этап дообучения с помощью RL: Модель дорабатывается, чтобы лучше соответствовать предпочтениям людей.
Рисунок: Описание трех стадий RLHF от OpenAI.
Как работает P3O?
Основная идея P3O заключается в использовании разницы между двумя ответами, а не абсолютного значения награды. Это делает обучение более гибким и устойчивым к проблемам.
Примеры из реальной жизни
Мы протестировали P3O на задачах суммаризации и ответов на вопросы. Например, для суммаризации использовался набор данных TL;DR, где модель училась генерировать краткие выводы к форумным постам с Reddit.
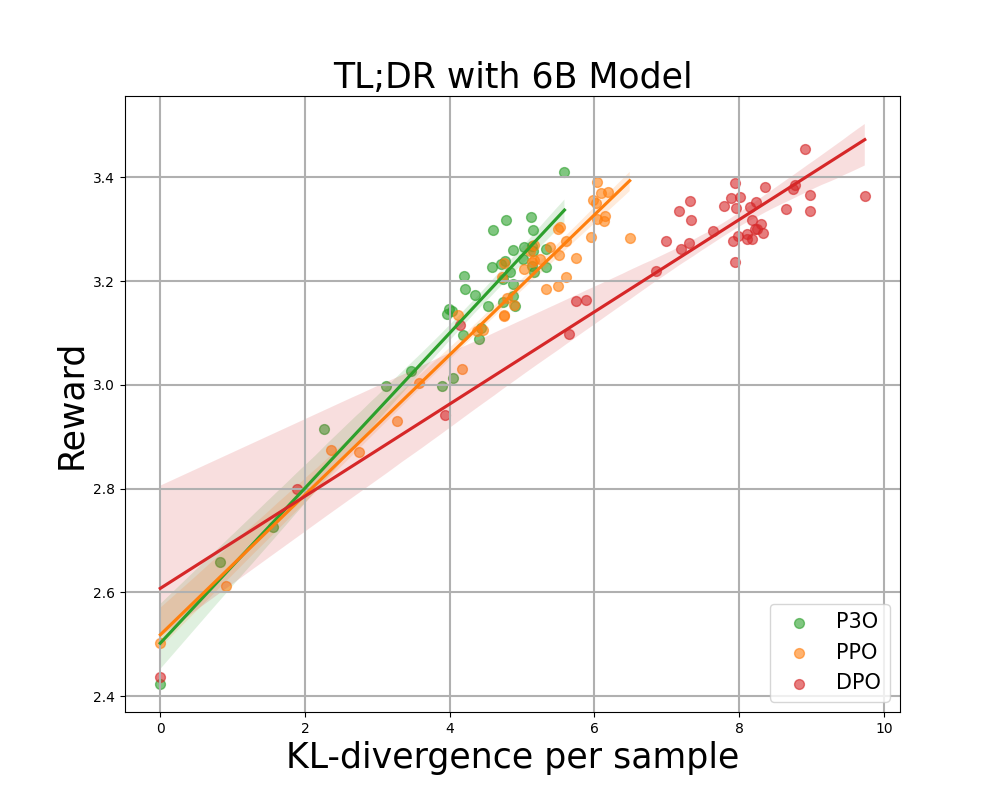
Рисунок: Примеры из задач TL;DR. P3O показал лучшие результаты по сравнению с другими методами.
Выводы и Следующие Шаги
Наша работа показывает, что P3O позволяет лучше согласовать модели с человеческими предпочтениями. Это делает виртуальных помощников еще более полезными и надежными. Если вы заинтересованы, прочитайте наш доклад и узнайте больше!
А как вы думаете, что еще можно улучшить в виртуальных ассистентах? Оставляйте свои мысли в комментариях ниже!