Влияние ИИ на выборы сильно преувеличено
14.09.2024
В центре внимания: Как создать топовую AI-практику в FinTech
15.09.2024Влияние ИИ на выборы сильно преувеличено
14.09.2024В центре внимания: Как создать топовую AI-практику в FinTech
15.09.2024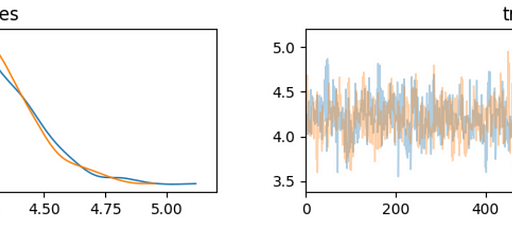
Хотите узнать, как строить модели Байесовской регрессии с нуля?
Привет! Если вы когда-нибудь задумывались о том, как работают Байесовские модели и как их реализовать, то вы по адресу. Байесовская регрессия — это мощный инструмент для анализа данных, и сегодня мы разберём, как создать простую линейную модель регрессии на языке STAN. Готовы? Поехали!
Начнём с примеров
Представим, что у нас есть зависимая переменная Y и независимая переменная X. Модель будет выглядеть так:
Y = α + β * X + ϵ
Где ⍺ — это интерцепт, β — наклон, а ϵ — случайная ошибка, подчиняющаяся нормальному распределению с мат. ожиданием 0 и дисперсией σ.
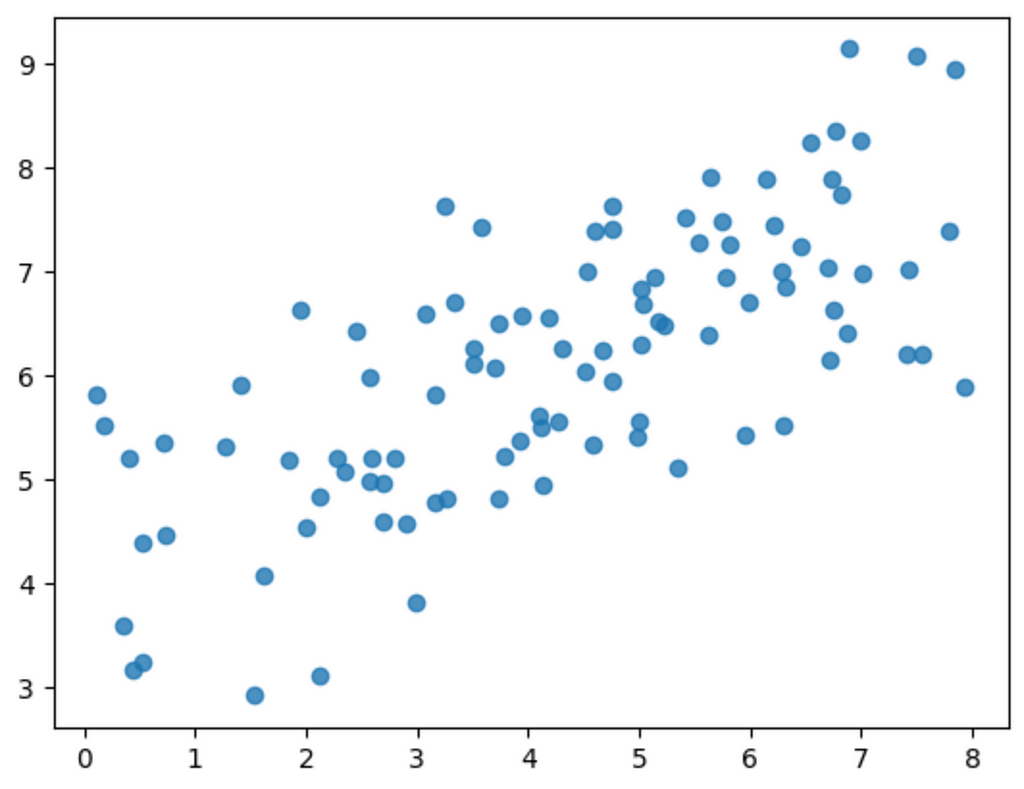
Теперь нам нужно сгенерировать данные, чтобы работать с ними в STAN:
«`python
# Параметры модели
alpha = 4.0 # интерцепт
beta = 0.5 # наклон
sigma = 1.0 # масштаб ошибки
# Генерация данных
import numpy as np
import matplotlib.pyplot as plt
x = 8 * np.random.rand(100)
y = alpha + beta * x
y = np.random.normal(y, scale=sigma)
# Визуализация данных
plt.scatter(x, y, alpha=0.8)
plt.show()
«`
Структура модели в STAN
Модель в STAN состоит из нескольких блоков: data, parameters, model, и generated quantities. Давайте разберём каждый блок.
Блок DATA
«`stan
data {
int
vector[N] x;
vector[N] y;
}
«`
Здесь мы задаём размер данных N, ковариат x и зависимую переменную y.
Блок Model
Здесь мы указываем структуру нашей модели:
«`stan
model {
alpha ~ normal(0, 10);
beta ~ normal(0, 1);
y ~ normal(alpha + beta * x, sigma);
}
«`
Мы также указываем prior для параметров α и β, что является важной частью Байесовского подхода.
Блок Generated Quantities
В этом блоке мы задаём, какие величины должны быть сгенерированы STAN на основании модели:
«`stan
generated quantities {
vector[N] yhat;
vector[N] log_lik;
for (n in 1:N) {
yhat[n] = normal_rng(alpha + x[n] * beta, sigma);
log_lik[n] = normal_lpdf(y[n] | alpha + x[n] * beta, sigma);
}
}
«`
Теперь, когда у нас есть все блоки, давайте соберём их вместе:
«`stan
model_code = «»»
data {
int
vector[N] x;
vector[N] y;
}
parameters {
real alpha;
real beta;
real
}
model {
alpha ~ normal(0, 10);
beta ~ normal(0, 1);
y ~ normal(alpha + beta * x, sigma);
}
generated quantities {
vector[N] yhat;
vector[N] log_lik;
for (n in 1:N) {
yhat[n] = normal_rng(alpha + x[n] * beta, sigma);
log_lik[n] = normal_lpdf(y[n] | alpha + x[n] * beta, sigma);
}
}
«»»
«`
Запуск модели
Компилируем модель и запускаем выборку:
«`python
import stan
data = {‘N’: len(x), ‘x’: x, ‘y’: y}
posterior = stan.build(model_code, data=data, random_seed=42)
fit = posterior.sample(num_chains=2, num_samples=1000, warmup=10)
«`
Оценка модели
Для оценки качества модели мы можем визуально изучить результаты выборки:

Также можно использовать Rhat для численной оценки сходимости.
Подведение итогов
Мы изучили, как строить первую простую модель Байесовской линейной регрессии в STAN. В следующем уроке мы углубимся в создание более сложных моделей.
Хотите больше узнать о Байесовском моделировании? Подписывайтесь на наш блог!