ИИ-агент или сотрудник: сравниваем расходы на одной задаче
13.09.2026
Поддержка ИИ-агента: что входит и как посчитать цену за месяц
14.09.2026ИИ-агент или сотрудник: сравниваем расходы на одной задаче
13.09.2026Поддержка ИИ-агента: что входит и как посчитать цену за месяц
14.09.2026
Если нужен ответ в одну строку: у нейросети нет одного изобретателя. Уоррен Маккаллок и Уолтер Питтс в 1943 году описали математическую модель сети из простых искусственных нейронов. Фрэнк Розенблатт в 1957–1958 годах предложил обучаемый перцептрон, а в 1960-м его команда публично показала аппаратную машину Mark I Perceptron. Но современная нейросеть появилась не в один день: ей понадобились алгоритмы обучения, многослойные архитектуры, большие данные и достаточно мощные компьютеры.
Поэтому вопрос «кто придумал нейросеть?» похож на вопрос «кто придумал авиацию?». Можно назвать авторов первой работающей конструкции, но Boeing из неё напрямую не выпадает. Здесь то же самое: между логическим нейроном 1943 года и ChatGPT лежит цепочка из десятков прорывов.
В этой статье я разложу историю по типам вклада. Не буду назначать одного «отца нейросетей» задним числом. Покажу, кто придумал модель, кто научил её менять веса, кто построил раннюю машину, кто сделал обучение многослойных сетей практичным и почему именно 2012 и 2017 годы стали поворотными.
Короткий ответ: кто придумал нейросеть и в каком году
Вот рабочая версия хронологии, которую можно сохранить:
| Что именно появилось | Год | Кого обычно указывают | Почему это важно |
|---|---|---|---|
| Формальная сеть искусственных нейронов | 1943 | Уоррен Маккаллок и Уолтер Питтс | Показали, как сеть простых пороговых элементов может выполнять логические вычисления |
| Правило усиления связей при совместной активности | 1949 | Дональд Хебб | Дал важную идею обучения через изменение связей |
| Ранняя физическая обучающаяся нейросетевая машина SNARC | 1951 | Марвин Минский и Дин Эдмондс | Перенёс идею из формул в электромеханическую систему |
| Обучаемый перцептрон | 1957–1958 | Фрэнк Розенблатт | Связал распознавание образов с автоматической настройкой весов |
| Mark I Perceptron | 1960 | Команда Розенблатта | Показала аппаратную систему распознавания изображений |
| Практическое обучение скрытых слоёв методом backprop | 1986 | Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс | Сделало многослойные сети реально обучаемыми на полезных задачах |
| Победа глубокой CNN на ImageNet | 2012 | Алекс Крижевский, Илья Суцкевер и Джеффри Хинтон | Соединила глубокую сеть, большой датасет и GPU в убедительный результат |
| Архитектура Transformer | 2017 | Ашиш Васвани и соавторы | Создала основу большинства современных больших языковых моделей |
| Публичный запуск ChatGPT | 2022 | OpenAI | Превратил сложную языковую модель в массовый разговорный продукт |
Если в тесте или викторине нужен один год, чаще всего ожидают 1943-й. Если спрашивают про первую обучаемую модель, уместнее назвать перцептрон Розенблатта, 1957–1958 годы. Если речь о первом аппаратном перцептроне — это Mark I, показанный в 1960 году. Контекст здесь решает всё.
Почему у слова «первая» сразу несколько правильных ответов
Исторические споры начинаются не из-за дат, а из-за подмены предмета. Под «первой нейросетью» могут иметь в виду пять разных вещей:
- математическую модель искусственного нейрона;
- сеть таких нейронов на бумаге;
- машину, которая физически реализует нейросетевой принцип;
- обучаемый алгоритм для распознавания;
- глубокую сеть, похожую по устройству обучения на современные модели.
Это не одно и то же. Маккаллок и Питтс не строили ChatGPT из ламп. Розенблатт не изобретал все нейросетевые архитектуры. Создатели Transformer не придумали искусственный нейрон заново. Каждый ответ верен только вместе с уточнением «что именно».
Полезно держать рядом и терминологическую карту: в статье о различиях между ИИ, машинным обучением, нейросетью и LLM я отдельно показываю, почему продукт, модель и научная область не складываются в одну простую матрёшку.
1943 год: Маккаллок и Питтс описывают вычисляющий нейрон
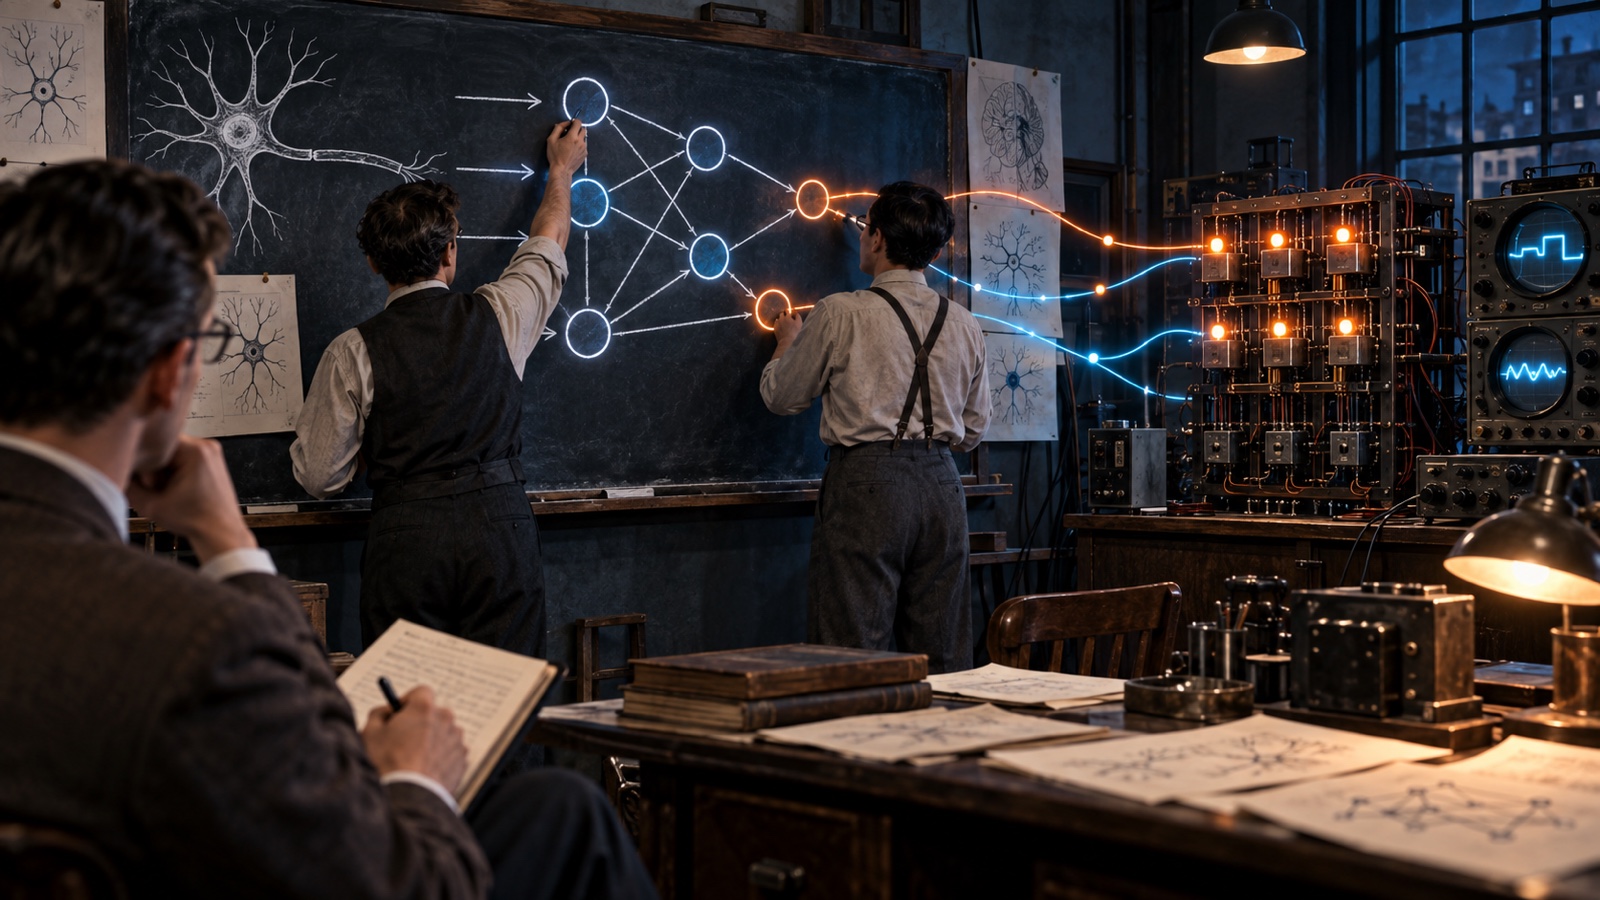
Точкой отсчёта обычно считают статью Уоррена Маккаллока и Уолтера Питтса A Logical Calculus of the Ideas Immanent in Nervous Activity, опубликованную в 1943 году.
Авторы предложили предельно упрощённую модель нервной клетки. Она получала несколько сигналов и выдавала ответ по принципу «сработала или нет», если возбуждение преодолело порог. Соединяя такие элементы в сеть, можно было представить логические операции.
Смотрите, в чём настоящий прорыв. Они не просто нарисовали клетку, похожую на биологический нейрон. Они связали работу сети с формальным вычислением. Мозг перестал быть только метафорой и превратился в объект, который можно описывать математически.
Но эта сеть не училась на данных в современном смысле. Её связи и правила задавались заранее. Поэтому формулировка «в 1943 году изобрели первую обучаемую нейросеть» неверна. В 1943-м появился фундамент: искусственный нейрон и логика сети.
1949 год: Хебб формулирует принцип изменения связей
Следующая проблема очевидна: сеть можно спроектировать, но как сделать так, чтобы она сама менялась после опыта?
В книге Дональда Хебба The Organization of Behavior 1949 года появилась идея, позже получившая название хеббовского обучения. В упрощённом пересказе: если клетки систематически активируются вместе, связь между ними усиливается.
Популярная фраза «neurons that fire together wire together» — удобное позднейшее резюме, а не буквальная цитата, которую стоит бездумно приписывать Хеббу. Смысл важнее афоризма: обучение можно представить как локальное изменение силы связей.
Современные нейросети обучаются сложнее. Они минимизируют функцию потерь, используют градиенты, оптимизаторы, регуляризацию и огромные наборы данных. Но идея, что знание хранится не в одном «умном нейроне», а в структуре и силе связей, стала важной частью будущей инженерии.
1951 год: SNARC переносит нейросеть с бумаги в машину
В 1951 году Марвин Минский и Дин Эдмондс собрали SNARC — Stochastic Neural-Analog Reinforcement Calculator. На архивной странице MIT о Минском SNARC назван первым симулятором нейронной сети. В диссертации Минского сохранилось описание машины и её механизма подкрепления.
SNARC моделировал поведение крысы в лабиринте с помощью случайно соединённых аналоговых элементов. Это был не универсальный классификатор и тем более не предок языковой модели в прямой инженерной линии. Его значение другое: исследователи показали, что адаптивную сеть можно воплотить в физическом устройстве, а не только обсуждать теоретически.
Отсюда ещё один корректный ответ: если под первой нейросетью понимать раннюю работающую нейросетевую машину, можно назвать SNARC 1951 года. Но в популярных хронологиях эту веху часто пропускают, потому что перцептрон сильнее связан с распознаванием образов и последующим машинным обучением.
1957–1960 годы: Розенблатт создаёт обучаемый перцептрон
Фрэнк Розенблатт сделал шаг, после которого история становится узнаваемой для современного специалиста по машинному обучению. Он предложил перцептрон — систему, которая меняет веса связей по примерам и учится разделять классы.
Его основная статья The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain вышла в 1958 году. Но работу над идеей и моделирование обычно датируют 1957-м. Поэтому в источниках встречаются оба года, и это не обязательно ошибка: один относится к разработке, другой — к публикации.
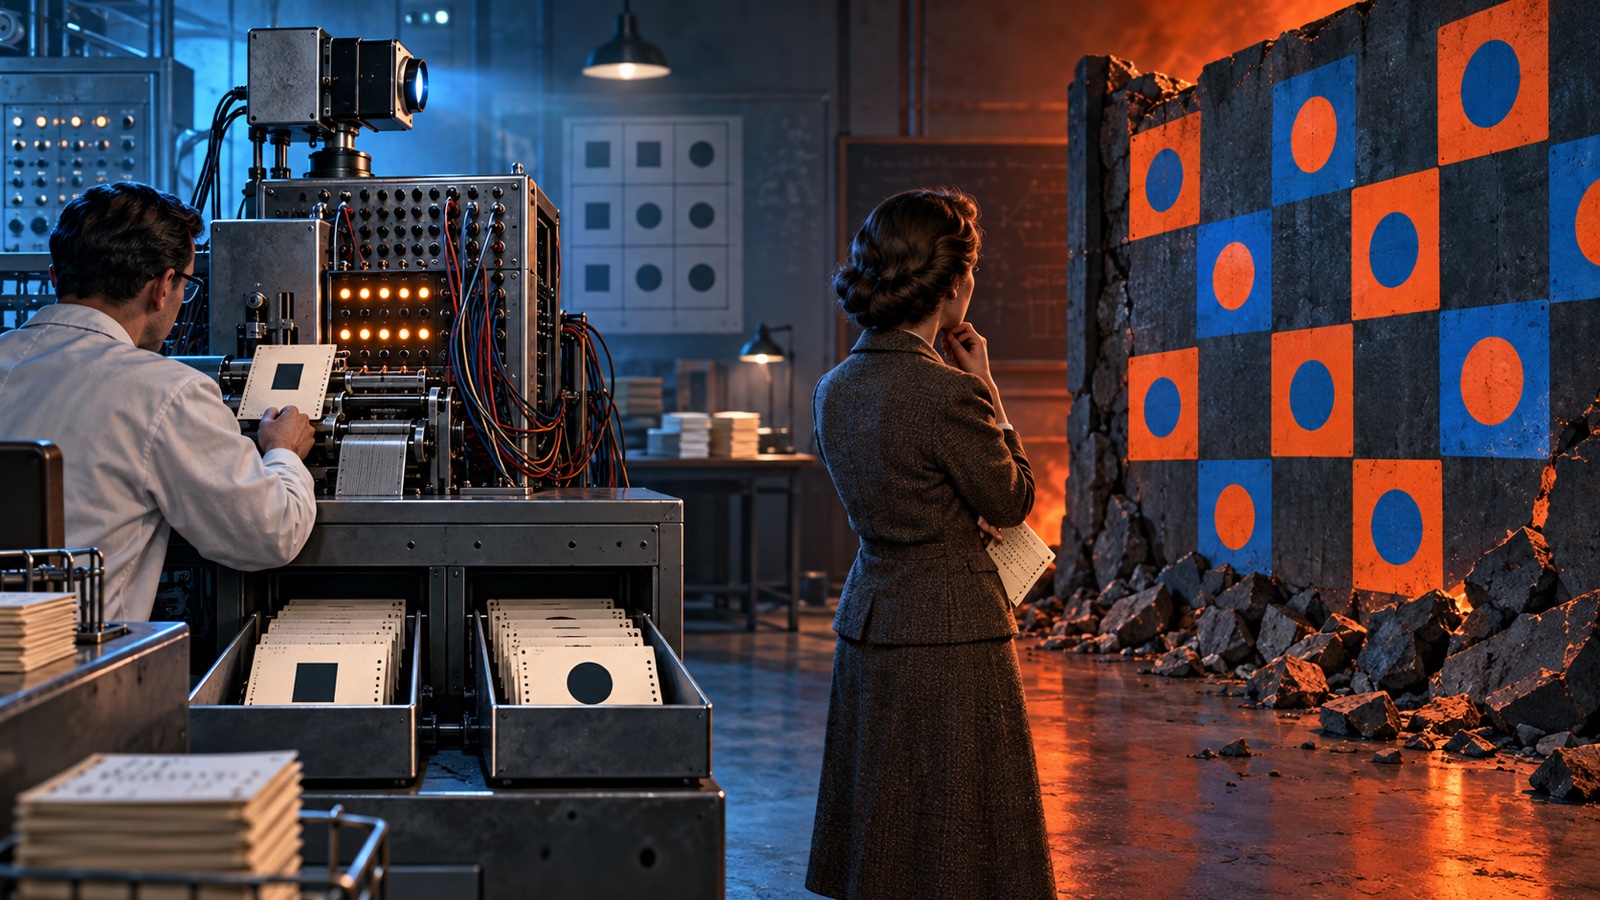
В 1960 году в Корнелле показали Mark I Perceptron. У машины был сенсорный массив, соединения с настраиваемыми весами и аппаратная логика классификации. Архив Корнеллского университета сохраняет фотографии, документы и описание этой демонстрации.
Здесь важно не повторять газетный миф о «машине, которая думает». Перцептрон решал узкую задачу классификации. Он не понимал изображение как человек и не обладал общей картиной мира. Зато он закрепил центральный инженерный принцип: вместо ручного программирования всех правил часть нужного поведения можно получить обучением весов на примерах.
1960 год: ADALINE показывает другой путь обучения
Параллельно Бернард Уидроу и Марсиан Хофф в Стэнфорде разработали ADALINE и правило настройки весов, известное как LMS или дельта-правило. Их работа Adaptive Switching Circuits описывает адаптивный нейрон и обучение через уменьшение средней квадратичной ошибки.
Эта ветка важна по двум причинам. Во-первых, она укрепила связь нейросетей с оптимизацией: вес меняется не магически, а в направлении уменьшения измеримой ошибки. Во-вторых, адаптивные системы вышли в реальные задачи обработки сигналов.
История нейросетей вообще плохо помещается в линейную легенду. Пока одна группа изучала распознавание образов, другая строила адаптивные фильтры, третья — модели памяти. Современная система унаследовала кусочки от всех этих ветвей.
1969 год и миф о том, что одна книга «убила» нейросети
В 1969 году Марвин Минский и Сеймур Пейперт выпустили книгу Perceptrons. Они строго разобрали возможности и ограничения определённого класса перцептронов. Самый известный популярный пример — невозможность для однослойного линейного классификатора решить XOR без изменения представления признаков.
Из этого часто делают киношную историю: два критика написали книгу, финансирование исчезло, наступила «зима нейросетей». Реальность скучнее и полезнее. Ограничения действительно были серьёзными, но к ним добавлялись слабые компьютеры, маленькие датасеты, трудность обучения нескольких слоёв и завышенные ожидания.
Главный урок не в том, что критика была вредной. Наоборот, она точно показала разрыв между обещаниями и доступной техникой. Плохой вывод звучит так: «перцептрон бесполезен». Хороший: «одного линейного слоя недостаточно для многих задач, а значит нужны новые архитектуры и способы обучения».
Кто придумал обратное распространение ошибки
Backpropagation часто приписывают Румельхарту, Хинтону и Уильямсу. Это справедливо, если добавить слово популяризировали для многослойных нейросетей. Но сама история алгоритма распределена между несколькими работами.
Обратный режим автоматического дифференцирования описывался раньше; Пол Вербос в диссертации 1974 года связал распространение производных назад с обучением динамических систем и нейросетевых моделей. В 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс опубликовали в Nature статью Learning representations by back-propagating errors, которая наглядно показала, как корректировать веса скрытых слоёв и получать внутренние представления полезных признаков.
Механика проста по идее, хотя объём вычислений огромен:
- сеть делает прямой проход и выдаёт прогноз;
- функция потерь измеряет ошибку;
- производные показывают вклад каждого веса в ошибку;
- градиент передаётся от выхода к ранним слоям;
- оптимизатор немного меняет веса;
- цикл повторяется на следующих примерах.
Если хотите увидеть эту механику без исторической рамки, в материале «Что такое нейросеть простыми словами» есть числовой пример одного нейрона, разница между обучением и инференсом и воспроизводимый эксперимент.
1980–1998 годы: сети памяти, свёртки и реальные документы
Возрождение нейросетей нельзя свести только к backprop.
В 1980 году Кунихико Фукусима представил neocognitron — иерархическую сеть для распознавания образов, устойчивую к сдвигам. Она стала важным предшественником свёрточных сетей. В 1982 году Джон Хопфилд описал рекуррентную сеть как ассоциативную память: система могла восстанавливать целый образ по неполному или зашумлённому входу.
В середине 1980-х Джеффри Хинтон и Терренс Сейновски развивали машину Больцмана — вероятностную сеть, которая училась обнаруживать структуру в данных. Значимость ветки памяти и статистической физики позже подчеркнула Нобелевская премия по физике 2024 года: официальная формулировка отметила Джона Хопфилда и Джеффри Хинтона за фундаментальные открытия и изобретения, сделавшие возможным машинное обучение с искусственными нейросетями.
Ян Лекун и коллеги в конце 1980-х применили backprop к распознаванию рукописных почтовых индексов. В обзоре 1998 года Gradient-Based Learning Applied to Document Recognition уже описана зрелая свёрточная система LeNet и практическое чтение чеков.
Это важная поправка к истории: нейросети не «умерли» до 2012 года. Они работали в узких областях раньше. Просто ещё не стали универсальной доминирующей технологией.
1997 год: LSTM учится не забывать длинный контекст
Обычным рекуррентным сетям трудно переносить полезный сигнал через длинную последовательность: градиент может затухать или взрываться. Зепп Хохрайтер и Юрген Шмидхубер предложили архитектуру Long Short-Term Memory. Их статья LSTM 1997 года описала ячейки и управляющие элементы, которые помогают сохранять информацию на больших временных интервалах.
Позже LSTM стали стандартным инструментом для речи, текста, временных рядов и машинного перевода. До Transformer именно рекуррентные сети такого типа были одним из главных способов работать с последовательностями.
Но не стоит рисовать прямую стрелку «LSTM → ChatGPT». Современные LLM в основном строятся на Transformer. LSTM важна как решение другого поколения и как доказательство, что архитектура должна учитывать тип зависимости в данных.
2006–2012 годы: глубина встречает данные и GPU
В 2006 году работа Джеффри Хинтона, Саймона Осиндеро и Йи-Вэя Тэ A Fast Learning Algorithm for Deep Belief Nets показала эффективный способ послойного предварительного обучения глубоких сетей. Сам термин «deep learning» существовал и раньше, но именно в середине 2000-х глубокие сети снова стали большой исследовательской программой.
Затем сошлись три линии:
- появились крупные размеченные датасеты;
- графические процессоры резко ускорили матричные вычисления;
- архитектуры и методы регуляризации стали устойчивее.
ImageNet, представленная как крупная иерархическая база изображений в работе 2009 года, дала общий полигон для сравнения моделей. В 2012 году AlexNet — глубокая свёрточная сеть Алекса Крижевского, Ильи Суцкевера и Джеффри Хинтона — выиграла ImageNet с большим отрывом. Исходная статья прямо отмечает обучение на GPU и сеть с 60 миллионами параметров.
2012-й стал не «годом изобретения нейросети», а годом убедительной демонстрации масштаба. После него спор сменился с «работает ли глубокое обучение?» на «где ещё оно сработает?».
Если вы хотите понять, что из этой истории можно реально запустить сегодня на своём железе, в статье о локальных нейросетях я отдельно развожу архитектуру, файл весов, программу запуска, RAM и VRAM.
2017 год: Transformer меняет работу с последовательностями
В 2017 году Ашиш Васвани и соавторы опубликовали Attention Is All You Need. Архитектура Transformer отказалась от обязательной рекуррентной обработки токенов по одному и построила модель вокруг механизма внимания.
Практический смысл: модель может эффективнее находить связи между частями последовательности и лучше использовать параллельные вычисления при обучении. Это не означает, что Transformer «понимает всё сразу» или хранит бесконечный контекст. Но архитектура оказалась исключительно масштабируемой.
На Transformer выросли BERT, семейство GPT и большинство современных LLM. Поэтому для истории ChatGPT 2017 год важнее, чем кажется: пользовательский чат появился позже, а его архитектурный фундамент — раньше.
2022 год: ChatGPT делает нейросеть массовым продуктом
30 ноября 2022 года OpenAI открыла исследовательский доступ к ChatGPT. Исходный анонс описывал разговорную модель, способную отвечать на уточнения, признавать ошибки, спорить с неверными предпосылками и отклонять неподходящие запросы.
ChatGPT не был первой нейросетью, первой языковой моделью или первым чат-ботом. Его историческая роль в другом: сложная модель получила простой интерфейс, понятный миллионам людей. Технология перестала жить только в лабораториях, API и узких продуктах.
Это полезно помнить и сейчас. ChatGPT — не фамилия изобретателя и не название архитектуры. Это продукт вокруг моделей. Если вам нужно выбрать современный сервис под задачу, используйте сравнение ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen и Perplexity, а не историческую репутацию бренда.
Пять мифов об истории нейросетей
Миф 1. Нейросеть придумал один человек
Нет. Маккаллок и Питтс дали формальную модель, Хебб — принцип изменения связей, Розенблатт — обучаемый перцептрон, Уидроу и Хофф — важный градиентный метод, а следующие поколения сделали глубокое обучение практичным.
Миф 2. Первая нейросеть появилась в 1958 году
Только если под нейросетью понимать перцептрон Розенблатта. Формальная сеть была описана в 1943-м, SNARC построен в 1951-м, статья о перцептроне опубликована в 1958-м, а Mark I показан в 1960-м.
Миф 3. Минский сначала изобрёл нейросеть, а потом запретил её
Минский участвовал в создании SNARC и позже вместе с Пейпертом строго исследовал ограничения перцептронов. Книга не была запретом. Спад интереса возник из сочетания технических ограничений, нехватки вычислений, недостатка данных и перегретых обещаний.
Миф 4. Backprop придумали в 1986 году с нуля
В 1986-м метод получил чрезвычайно влиятельную нейросетевую демонстрацию и объяснение. Но идеи автоматического дифференцирования и применения обратного вычисления производных развивались раньше. Честная формулировка здесь важнее простого имени.
Миф 5. Нейросети стали полезными только после ChatGPT
К 1990-м свёрточные сети уже читали рукописные символы, LSTM работали с последовательностями, а в 2012 году глубокая CNN убедительно победила в компьютерном зрении. ChatGPT сделал нейросетевой продукт массовым, но не начал историю.
Как проверить любую хронологию за 20 минут
Исторические статьи любят копировать друг у друга красивый таймлайн. Одна неверная дата размножается на сотни страниц. Вот воспроизводимый протокол проверки.
- Сформулируйте объект. Вы проверяете первую формальную модель, публикацию, аппаратную машину, алгоритм обучения или массовый продукт?
- Найдите первичную работу. Нужны авторы, название, журнал или издательство, год и DOI.
- Разделите создание и публикацию. Перцептрон разрабатывался в 1957-м, статья вышла в 1958-м, аппаратная демонстрация состоялась в 1960-м.
- Проверьте, что утверждает сам источник. Современный пересказ может приписать работе больше, чем в ней было.
- Не путайте предшественника и прямую архитектуру. Neocognitron предвосхитил CNN, но не был AlexNet. LSTM изменила последовательностные модели, но ChatGPT основан не на LSTM.
- Сохраните два источника для спорной вехи. Для SNARC полезно держать архив MIT и диссертацию Минского; для перцептрона — статью и архив Корнелла.
Попробуйте на одном утверждении: «первая нейросеть появилась в 1958 году». Через несколько минут станет видно, что факт без определения слова «первая» неполон. Это и есть главный навык фактчекинга — не искать удобную дату, а уточнять предмет.
Кому принадлежит какой вклад
Если нужно быстро и без путаницы распределить заслуги, используйте такую карту:
| Человек или команда | Корректная короткая формулировка |
|---|---|
| Уоррен Маккаллок и Уолтер Питтс | Авторы формальной модели сети пороговых искусственных нейронов, 1943 |
| Дональд Хебб | Автор влиятельного принципа обучения через усиление связей, 1949 |
| Марвин Минский и Дин Эдмондс | Создатели ранней физической нейросетевой машины SNARC, 1951 |
| Фрэнк Розенблатт | Автор обучаемого перцептрона и руководитель работ над Mark I |
| Бернард Уидроу и Марсиан Хофф | Создатели ADALINE и LMS-обучения для адаптивных систем |
| Джон Хопфилд | Автор влиятельной рекуррентной сети ассоциативной памяти |
| Румельхарт, Хинтон и Уильямс | Авторы ключевой работы, популяризировавшей backprop для скрытых слоёв |
| Кунихико Фукусима и Ян Лекун | Ключевые фигуры в развитии и практическом успехе свёрточных сетей |
| Хохрайтер и Шмидхубер | Авторы LSTM |
| Крижевский, Суцкевер и Хинтон | Авторы AlexNet, показавшей масштаб глубокого обучения на GPU |
| Васвани и соавторы | Авторы Transformer |
Эта таблица намеренно не заканчивается словом «изобретатель» в каждой строке. Наука редко развивается как патент на чайник. Кто-то формулирует принцип, кто-то делает алгоритм обучаемым, кто-то строит машину, кто-то соединяет известные идеи в систему, которая наконец масштабируется.
Зачем эта история нужна обычному пользователю
Во-первых, она лечит от магии. Современная нейросеть — не внезапно проснувшийся электронный мозг. Это обучаемая математическая система, выросшая из пороговых элементов, оптимизации, архитектур и вычислительной инфраструктуры.
Во-вторых, история объясняет ограничения. Линейный перцептрон не решает любую задачу только потому, что он учится. Глубокая сеть не становится точной без данных. Большая модель не гарантирует фактическую верность. Каждый прорыв закрывал один барьер и открывал следующий.
В-третьих, становится проще выбирать инструменты. Вам не нужна «самая исторически важная нейросеть». Вам нужен подходящий продукт под конкретную задачу, бюджет, данные и риск. Для первого практического шага есть маршрут «Нейросети с нуля», а системное обучение собрано на странице программ Ильи Шведкова по нейросетям.
Частые вопросы
Кто считается создателем первой нейросети
Чаще всего называют Уоррена Маккаллока и Уолтера Питтса: в 1943 году они опубликовали формальную модель сети искусственных нейронов. Для первой обучаемой модели обычно называют Фрэнка Розенблатта и его перцептрон.
Когда появилась первая нейросеть
Базовая формальная модель — 1943 год. Физическая машина SNARC — 1951 год. Перцептрон разработан в 1957-м, статья опубликована в 1958-м, аппаратный Mark I продемонстрирован в 1960-м.
Кто создал первый искусственный нейрон
Математическую модель порогового искусственного нейрона обычно связывают с Уорреном Маккаллоком и Уолтером Питтсом и их работой 1943 года.
Кто придумал перцептрон
Перцептрон создал американский психолог Фрэнк Розенблатт. Работу над моделью датируют 1957 годом, основная статья вышла в 1958-м, аппаратная система Mark I была публично показана в 1960-м.
Кто придумал backpropagation
У алгоритма нет одного бесспорного автора. Ранние идеи обратного автоматического дифференцирования и применения производных к обучению появились до 1986 года. Румельхарт, Хинтон и Уильямс сделали backprop широко известным и практичным для обучения скрытых слоёв нейросети.
Почему нейросети долго не развивались
Они развивались, но волнами. Мешали ограниченные компьютеры, маленькие датасеты, трудность обучения глубоких сетей, архитектурные ограничения и разрыв между обещаниями и результатами.
Когда появились современные нейросети
Зависит от определения. Backprop для многослойных сетей получил ключевую популяризацию в 1986-м, современные CNN доказали практическую силу в 1990-х и особенно в 2012-м, Transformer появился в 2017-м, а массовый разговорный продукт ChatGPT — в 2022-м.
Нейросеть скопирована с человеческого мозга
Она вдохновлена очень упрощёнными представлениями о нейронах и связях, но современная искусственная сеть не является цифровой копией мозга. Её узлы, функции активации, обучение и масштабы — инженерная математика, а не точная биологическая модель.
Вывод: нейросеть придумала эстафета, а не один гений
Самый честный короткий ответ такой: Маккаллок и Питтс заложили формальный фундамент в 1943 году, Розенблатт создал обучаемый перцептрон в 1957–1958 годах, а современное глубокое обучение выросло из множества последующих работ.
Мне нравится эта версия истории больше легенды об одном изобретателе. Она показывает реальную механику прогресса: идея может десятилетиями ждать подходящего алгоритма, датасета, железа и интерфейса. А когда все детали сходятся, общество воспринимает результат как внезапное чудо.
Если хотите перейти от истории к практике, начните с часового маршрута по нейросетям для новичка: выберите одну задачу, получите первый результат и проверьте его по понятным критериям. Автор материала — Илья Шведков.