Бюджет на ИИ-агента: пример сметы на запуск, месяц и первый год
10.09.2026
ROI ИИ-агента: пример расчёта затрат и экономического эффекта
12.09.2026Бюджет на ИИ-агента: пример сметы на запуск, месяц и первый год
10.09.2026ROI ИИ-агента: пример расчёта затрат и экономического эффекта
12.09.2026
Нейросеть — это программа, которая учится находить закономерности в примерах, а затем использует их для прогноза. Показали ей много писем со словами «спам» и «не спам» — она учится оценивать новое письмо. Дали пары «текст — продолжение» — учится предсказывать следующий фрагмент. Дали изображения и подписи — связывает визуальные признаки со словами.
Звучит почти скромно. Никакого электронного мозга в стеклянной банке. Но когда таких настраиваемых связей миллионы или миллиарды, а примеров очень много, система начинает решать задачи, для которых невозможно вручную выписать все правила.
Мой главный тезис: нейросеть не хранит готовую инструкцию на каждый случай. Она хранит числовую настройку, которая превращает входные данные в вероятный ответ. Это объясняет и её силу, и странности. Почему она узнаёт кота под непривычным углом? Потому что уловила полезные признаки. Почему уверенно ошибается? Потому что выбирает правдоподобный результат, а не сверяется с универсальной базой истины.
Ниже разберём один маленький пример, пройдём весь путь от данных до ответа и отделим нормальную техническую модель от мифов. Формулы будут, но одна — и та на уровне школьного умножения.
Короткий ответ: что значит «нейросеть»
Если совсем просто, нейросеть — это математическая модель из связанных вычислительных узлов. Она принимает числа, последовательно преобразует их и выдаёт другие числа: вероятность класса, прогноз, следующий токен, координаты объекта, звук или элементы изображения.
| Вопрос | Короткий ответ |
|---|---|
| Что получает нейросеть | Числа: пиксели, признаки, токены, отсчёты звука или другие числовые представления |
| Что находится внутри | Слои вычислительных узлов, веса, смещения и функции активации |
| Что происходит при обучении | Алгоритм сравнивает прогноз с правильным ответом и понемногу меняет параметры |
| Что происходит при использовании | Уже обученная модель считает ответ для новых данных; это называется инференсом |
| Где хранится «знание» | Не в одном файле с правилами, а распределённо в числовых параметрах модели |
| Почему ответ бывает неверным | Модель оптимизирует прогноз по данным и цели обучения, но не получает встроенной гарантии истины |
Google определяет нейросети как семейство архитектур, которые находят нелинейные закономерности в данных. В учебном модуле Google о нейронных сетях отдельно разбираются узлы, скрытые слои, функции активации, инференс и обучение через обратное распространение ошибки.
Слово «нейронная» появилось из-за очень вольной аналогии с мозгом. Она помогает представить сеть связей, но быстро начинает мешать. Программный нейрон не живёт, не хочет, не вспоминает детство и не понимает задачу так, как человек. Это небольшое вычисление над числами.
Один игрушечный нейрон: считаем ответ руками
Возьмём фильтр почты. Пусть он оценивает, похоже ли письмо на спам, по трём признакам:
- Есть ли в теме слово «срочно»: 1 или 0.
- Есть ли подозрительная ссылка: 1 или 0.
- Знаком ли отправитель: 1 или 0.
Каждому признаку модель назначает вес. В нашем учебном примере «срочно» получает 0,8, ссылка — 0,7, знакомый отправитель — −0,9. Ещё есть смещение −0,4, которое задаёт исходный порог.
Для письма со словом «срочно», ссылкой и незнакомым отправителем получается:
0,8 × 1 + 0,7 × 1 − 0,9 × 0 − 0,4 = 1,1
Затем число проходит через функцию активации. Если взять сигмоиду, 1,1 превращается примерно в 0,75. В нашем игрушечном мире это можно прочитать как 75-процентную оценку класса «спам».
Важно: это не промышленный спам-фильтр и не его реальные коэффициенты. Это воспроизводимый пример, который показывает механику одного узла: взять входы, умножить на веса, сложить, добавить смещение и применить преобразование.
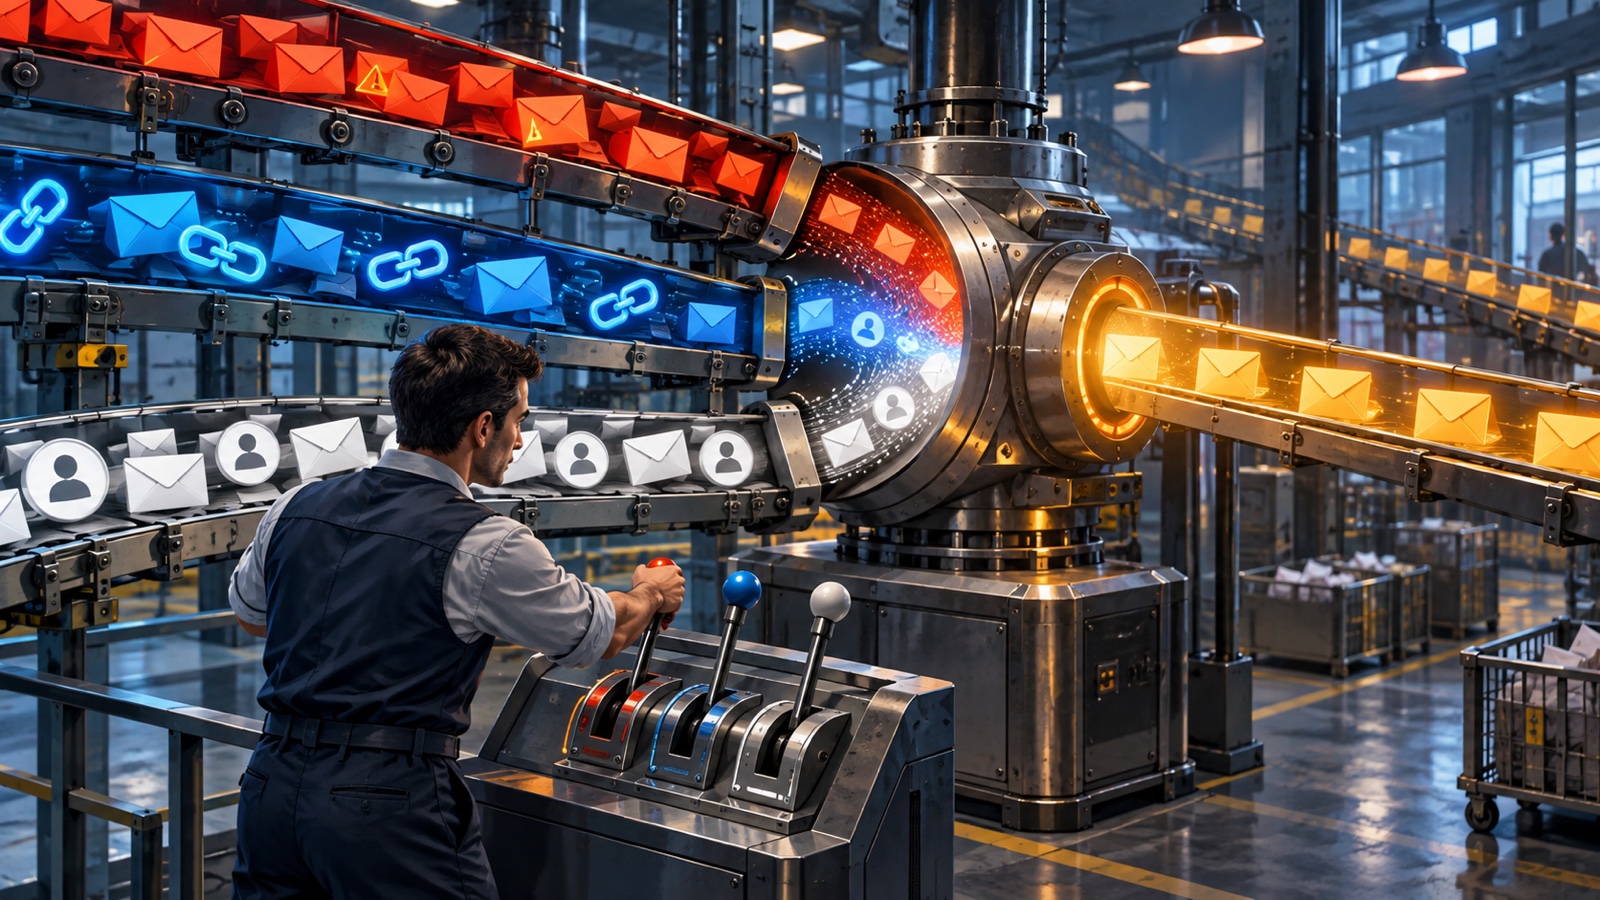
Если изменить знакомство с отправителем с 0 на 1, итоговый счёт до активации упадёт с 1,1 до 0,2. Значит, этот признак тянет решение в сторону «не спам». Вот где начинается интересное: во время обучения веса не пишет аналитик вручную. Модель подбирает их по примерам.
Из чего состоит нейросеть
Входной слой
Входной слой принимает данные в числовом виде. Для небольшой таблицы это могут быть цена, возраст объекта и площадь. Для изображения — значения пикселей или подготовленные признаки. Для текста — идентификаторы токенов и их числовые представления.
Нейросеть не принимает «кота» как готовое человеческое понятие. Сначала система получает массив чисел. Уже следующие преобразования могут выделить границы, фактуры, формы и более сложные сочетания.
Скрытые слои
Скрытые слои находятся между входом и результатом. Каждый узел берёт значения предыдущего слоя, умножает их на собственные веса, складывает, добавляет смещение и передаёт результат дальше.
Слово «скрытые» не означает секретные. Просто пользователь обычно видит вход и выход, а промежуточные значения остаются внутри модели. В интерактивном объяснении узлов и скрытых слоёв Google можно пошагово менять входы, веса и смещения и наблюдать, как пересчитывается результат.
Функция активации
Если каждый слой будет только умножать и складывать числа, стопка слоёв останется одним большим линейным преобразованием. Она не сможет описать многие изгибающиеся и составные закономерности.
Функция активации добавляет нелинейность. Например, ReLU возвращает ноль для отрицательного входа и само число для неотрицательного. Google подробно показывает, зачем нейросетям нужны функции активации и почему одних линейных слоёв недостаточно.
Выходной слой
Выход зависит от задачи. В классификаторе писем это может быть вероятность спама. В распознавании объектов — вероятности классов и координаты. В языковой модели — оценки вероятности следующего токена. В генераторе изображения — последовательность вычислений, из которой получается массив пикселей.
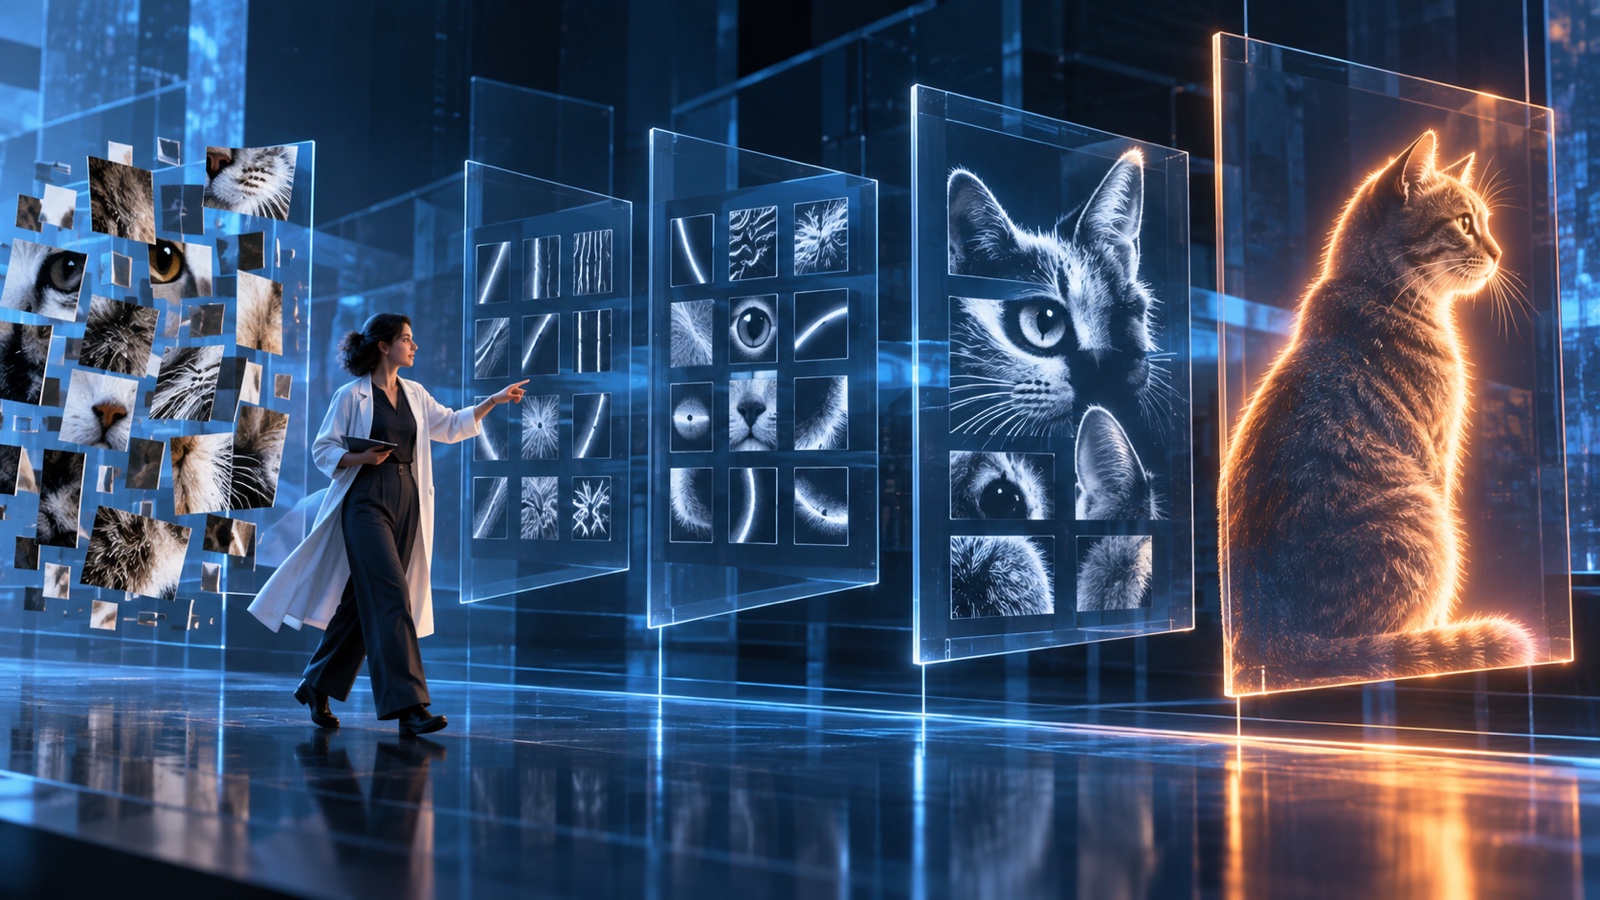
Не стоит понимать это как аккуратную картотеку: «этот нейрон отвечает за ухо, следующий — за кота». Иногда отдельные узлы действительно сильно реагируют на понятные признаки, но полезное представление обычно распределено по множеству параметров.
Как нейросеть обучается: пять шагов без математической стены
Обучение можно представить как многократную настройку огромного пульта. На нём не три ручки, как в нашем письме, а очень много. Каждый цикл состоит из пяти действий.
1. Подать пример
Модель получает вход. Например, письмо с известной меткой «спам». Данные до этого очищают и переводят в числовую форму.
2. Сделать прогноз
Случайно или предварительно заданные веса дают первый ответ. В начале он часто плохой: допустим, модель оценила спам всего в 20%.
3. Измерить ошибку
Функция потерь показывает, насколько прогноз разошёлся с правильным ответом. В объяснении Google loss — это числовая мера ошибки прогноза; цель обучения — уменьшать её.
4. Понять вклад параметров
Обратное распространение ошибки вычисляет, в какую сторону каждый параметр повлиял на итог. Это не команда «запомни конкретное письмо». Это расчёт чувствительности: какую ручку и куда стоит чуть повернуть, чтобы ошибка стала меньше.
5. Обновить веса и повторить
Оптимизатор делает небольшой шаг. Модель снова смотрит на примеры, снова ошибается и снова корректирует параметры. Обратное распространение остаётся основным способом обучать многослойные сети, а библиотеки машинного обучения автоматизируют эти вычисления.
Короче говоря, модель учится так: пример → прогноз → ошибка → поправка → следующий пример. Масштаб, архитектура и алгоритмы усложняются, принцип остаётся узнаваемым.
Обучение и работа готовой модели — разные процессы
Эти два этапа постоянно смешивают.
Обучение меняет параметры модели. Оно требует набора данных, вычислений, цели и проверки качества. Инференс берёт уже настроенные параметры и считает ответ для нового входа. Когда вы отправляете сообщение в чат, модель обычно не переобучает все свои веса на вашей фразе. Она выполняет инференс с переданным контекстом и подключёнными инструментами.
| Обучение | Инференс |
|---|---|
| Модель видит много примеров | Модель получает новый запрос |
| Вычисляется ошибка | Считается прогноз |
| Веса обновляются | Основные веса не меняются |
| Нужны циклы и значительные ресурсы | Обычно нужен один проход или последовательность проходов |
| Результат — новая версия параметров | Результат — ответ, класс, число, изображение или другой вывод |
Есть системы с памятью, дообучением, поиском по базе и инструментами. Но память приложения, контекст текущего диалога и изменение весов модели — три разных механизма. Если это не разделять, появляется миф: «нейросеть запомнила всё, что я ей написал». На практике путь данных зависит от конкретного сервиса и его настроек.
Если вас интересует запуск уже обученной модели без облачного чата, посмотрите разбор локальной нейросети на компьютере: там отдельно объяснены файл весов, программа запуска, RAM, VRAM и границы локальной приватности.
Откуда нейросеть берёт знания
Не из одного места. Её поведение формируют несколько слоёв работы:
- данные предварительного обучения;
- архитектура и цель обучения;
- последующее дообучение и настройка поведения;
- текущий запрос и контекст;
- подключённый поиск, база знаний, калькулятор или другой инструмент;
- правила продукта вокруг самой модели.
Поэтому фраза «нейросеть знает интернет» неточна. Часть закономерностей могла попасть в параметры во время обучения. Но модель не обязана помнить точную страницу, свежую дату или источник числа. Если приложение подключает веб-поиск, это уже отдельный шаг: система находит документы, передаёт их модели и просит собрать ответ.
Качество данных важно не меньше размера сети. В модуле Google о характеристиках датасетов перечислены табличные, текстовые и мультимедийные данные, ошибки разметки, шум и пропуски. Большой набор не становится хорошим автоматически.
Вот практический вывод. Если вам нужен ответ по конкретному PDF, не спрашивайте модель «из памяти». Загрузите документ в подходящий сервис, попросите указать страницу и проверьте цитату. В отдельном материале я разобрал, какие нейросети действительно принимают документы, фото, аудио и видео и что они фактически анализируют внутри файла.
Как работает языковая нейросеть вроде той, что стоит за чатом
Большая языковая модель, или LLM, — один из видов нейросетей. Она работает не с целыми мыслями, а с токенами: кусочками слов, словами, знаками и другими элементами. Модель оценивает, какое продолжение вероятно в данном контексте, выбирает следующий токен и повторяет расчёт.
Официальный курс Google по большим языковым моделям описывает языковую модель как систему, которая оценивает вероятность токена или последовательности токенов внутри более длинной последовательности. Современные LLM используют механизм внимания, чтобы учитывать связи между частями контекста.
«Предсказывает следующий токен» не означает «только автодополнение телефона, но побольше». Чтобы хорошо продолжать код, объяснение, диалог и разные стили, модель должна уловить огромное количество закономерностей. Из них появляются полезные способности. Но базовая задача прогноза всё равно не превращается в гарантию факта.
ChatGPT, Claude, Gemini и другие названия могут обозначать продукт, семейство моделей или оба уровня сразу. Чтобы не смешивать интерфейс, модель и режим работы, используйте карту сравнения ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen и Perplexity.
Почему нейросеть может решать новую задачу
Если модель только копировала бы примеры, она была бы дорогой поисковой таблицей. Полезность появляется из-за обобщения: сеть находит закономерности, которые помогают обработать вход, не встречавшийся в точности раньше.
Например, классификатор обучали на фотографиях кошек в разных комнатах, при разном свете и с разных ракурсов. Хорошая модель должна выделить признаки, полезные для новых снимков, а не правило «если фон зелёный, значит кошка».
Но здесь есть ловушка. Модель может слишком хорошо подстроиться под тренировочный набор и хуже работать на новых данных. Это называется переобучением. Google приводит точную проверку: модель отлично показывает себя на обучающих примерах, но ошибается на новых. Поэтому данные делят как минимум на обучающую и тестовую части, а часто ещё выделяют проверочную. Подробная схема есть в руководстве по разделению датасета.
Поэтому нормальный вопрос к любой нейросети звучит не «сколько у неё параметров?», а «на каких данных и критериях проверили нужную мне задачу?». Размер может помочь, но не отменяет качество данных, архитектуру, настройку и тестирование.
Для чего нужны нейросети
Нейросети особенно полезны там, где правила трудно перечислить вручную, а примеров достаточно, чтобы выучить закономерность.
- Текст: классификация, поиск смысла, перевод, суммаризация, генерация и редактура.
- Изображения: распознавание объектов, улучшение фото, сегментация, генерация и редактирование.
- Звук: распознавание речи, синтез голоса, разделение дорожек, генерация музыки.
- Видео: анализ кадров, генерация движения, субтитры и некоторые монтажные операции.
- Табличные и сенсорные данные: прогноз, обнаружение аномалий, оценка риска и рекомендации.
- Код: дополнение, объяснение, поиск ошибок и работа с проектом через инструменты.
Здесь важно не перепутать возможность и готовое решение. Нейросеть может написать функцию, но рабочий продукт требует тестов. Может разобрать договор, но юридическое решение остаётся за человеком. Может сгенерировать изображение, но права, сходство с брендом и соответствие задаче никто не отменял.
Если вам нужен не словарь терминов, а первый полезный результат, переходите к практическому маршруту «Нейросети с нуля». Там одна задача проходит путь от первого запроса до проверки за 60 минут.
Что нейросеть не умеет сама по себе
Не хранит гарантированную истину
Параметры кодируют выученные закономерности, а не подписанную справку на каждый факт. Свежие цены, законы, расписания и характеристики нужно получать из актуального источника.
Не определяет вашу цель
Модель может оптимизировать заданный показатель и всё равно решить не ту проблему. Если бизнес попросил «больше заявок», а в данных наградили клики, система научится искать клики.
Не понимает цену ошибки без правил
У рекомендации фильма и дозировки лекарства разная цена ошибки. Сама архитектура нейросети не назначает ответственность, пороги, согласование и контроль доступа.
Не превращает плохие данные в хорошие
Повторяющаяся ошибка в разметке становится закономерностью. Непредставительная выборка ограничивает результат. Слишком простой тест скрывает провал на реальных данных.
Не объясняет каждое решение человеческим правилом
Можно анализировать признаки, внимание, чувствительность и ошибки, но большая сеть не обязана выдавать короткое и полное правило для каждого ответа. Уверенное объяснение самой модели тоже следует проверять: оно может быть правдоподобным пересказом, а не точным журналом внутренних вычислений.
Нейросеть, алгоритм, программа и база данных: в чём разница
| Понятие | Что делает | Откуда берётся логика |
|---|---|---|
| Обычная программа | Выполняет явно заданные инструкции | Правила пишет разработчик |
| База данных | Хранит и возвращает записи | Данные и запросы задают люди и системы |
| Алгоритм | Описывает последовательность действий | Шаги определены заранее |
| Модель машинного обучения | Строит прогноз по выученным параметрам | Параметры подбираются по данным |
| Нейросеть | Один из классов моделей машинного обучения | Слои и связи настраиваются в процессе обучения |
Реальный AI-продукт часто объединяет всё сразу. Чат хранит историю в базе, выполняет обычный код, вызывает поиск, передаёт контекст нейросети и форматирует ответ программными правилами. Поэтому «это сделала нейросеть» иногда означает целую систему вокруг модели.
Подробную границу между ИИ, машинным обучением, LLM и нейросетью разберём в следующем материале контент-кластера. Пока достаточно одной вложенности: искусственный интеллект — широкая область; машинное обучение — один из подходов; нейросети — класс моделей внутри машинного обучения; LLM — крупные языковые модели на основе нейросетевых архитектур.
Проверяем механику сами за 10 минут
Откройте официальный TensorFlow Playground. Это учебная нейросеть прямо в браузере. Она показывает точки двух классов, связи между узлами, веса, обучающую и тестовую ошибку.
Выполните один и тот же эксперимент:
- Выберите набор, где один цвет окружает другой.
- Оставьте два входных признака.
- Начните с одного скрытого слоя и двух узлов.
- Запустите обучение и дождитесь стабилизации ошибки.
- Добавьте узлы, затем второй слой. Каждый раз сбрасывайте и запускайте модель заново.
- Увеличьте шум и сравните обучающую ошибку с тестовой.
Не ищите «победное число». Смотрите на три вещи: как меняется граница между цветами, какие связи усиливаются и что происходит с ошибкой на новых точках. Слишком простая сеть не согнёт границу как нужно. Слишком сложная может начать подстраиваться под шум. Это и есть компактная демонстрация представительной мощности, обучения и риска переобучения.
Эксперимент честный, потому что вы можете повторить его сами и увидеть процесс. Я не приписываю конкретные результаты вашей конфигурации: случайная инициализация, шум, скорость обучения и выбранная структура меняют картину.
Семь мифов о нейросетях
«Нейросеть работает как человеческий мозг»
Только на уровне очень общей метафоры связанных элементов. Современные архитектуры, обучение и представление данных не являются цифровой копией мозга.
«Она хранит все обучающие примеры»
Обычно модель учит распределённые параметры, а не создаёт доступный каталог исходников. Это не исключает запоминания отдельных фрагментов и не снимает вопросы к данным, но механика отличается от обычной базы.
«Большая модель всегда лучше маленькой»
Нет. Маленькая специализированная модель может выигрывать на узкой задаче, работать дешевле и запускаться локально. Проверяйте нужную задачу, а не только число параметров.
«Если ответ звучит уверенно, он точный»
Стиль и истинность — разные свойства. Нейросеть умеет производить гладкий текст и при ошибке.
«Нейросеть постоянно учится на моём чате»
Контекст диалога, память продукта, использование данных провайдером и переобучение весов — разные процессы. Смотрите правила конкретного сервиса.
«Достаточно написать хороший промпт»
Промпт важен, но не исправляет устаревший источник, отсутствующий файл, неподходящую модель и плохой процесс проверки.
«Нейросеть заменяет всю программу»
В рабочей системе модель обычно окружена обычным кодом, данными, интерфейсом, инструментами, ограничениями и журналированием.
Как пользоваться нейросетью безопаснее и точнее
Для обычной задачи хватит короткого цикла:
- Опишите результат и критерии готовности.
- Дайте только нужный контекст без лишних персональных данных и секретов.
- Попросите отделить факты от предположений.
- Для меняющихся сведений потребуйте первичные источники и откройте их сами.
- Проверьте числа, имена, даты, ссылки и критические решения.
- Сохраните удачный процесс, а не один красивый ответ.
Когда выбираете сервис под задачу, полезнее смотреть на доступные инструменты, файлы, поиск, правила данных и цену, чем на слово «самая умная». Для этого есть отдельная матрица выбора нейросети по типу задачи.
Частые вопросы
Что такое нейросеть одним предложением?
Нейросеть — это математическая модель из связанных вычислительных узлов, которая учится на примерах и затем строит прогноз для новых данных.
Что значит «нейросеть обучается»?
Алгоритм многократно сравнивает прогноз с правильным ответом, измеряет ошибку и меняет числовые параметры так, чтобы похожие задачи решались точнее.
Из чего состоит нейросеть?
Из входных данных, слоёв узлов, весов, смещений, функций активации и выходного слоя. В реальном продукте вокруг модели также работают код, базы, поиск и интерфейс.
По какому принципу работает нейросеть?
Она последовательно умножает входные значения на веса, складывает их, применяет нелинейные преобразования и получает выход. Во время обучения веса корректируются по ошибке.
Чем нейросеть отличается от искусственного интеллекта?
ИИ — более широкая область систем, решающих задачи, которые связывают с интеллектуальным поведением. Нейросеть — один класс моделей машинного обучения, который может быть частью такой системы.
ChatGPT — это нейросеть?
В основе ChatGPT работают большие языковые нейросетевые модели, но сам ChatGPT — продукт шире модели: интерфейс, память, поиск, файлы, инструменты, правила доступа и другие компоненты.
Нейросеть понимает, что пишет?
Она обрабатывает числовые представления и строит прогноз по выученным закономерностям. Полезное поведение может выглядеть как понимание, но уверенный текст сам по себе не доказывает человеческого понимания или истинности ответа.
Может ли нейросеть работать без интернета?
Да, если обученная модель и программа инференса запущены локально. Интернет может понадобиться для загрузки модели, обновлений, поиска или облачных инструментов.
Главный вывод
Нейросеть перестаёт быть магией, когда вы видите четыре вещи: данные, параметры, ошибку и проверку на новых примерах. Данные дают опыт. Параметры хранят настройку. Ошибка направляет обучение. Новые примеры показывают, научилась ли модель закономерности или просто подстроилась под тренировку.
Отсюда и практическое отношение. Не нужно бояться «электронного разума» и не стоит верить каждому гладкому ответу. Нужно понимать задачу, давать контекст, проверять важные факты и выбирать модель вместе с процессом вокруг неё.
Если хотите перейти от объяснения к действию, начните с бесплатного маршрута «Нейросети с нуля: первый полезный результат за 60 минут». А для системной практики посмотрите программы обучения нейросетям Ильи Шведкова и принесите на занятие одну реальную обезличенную задачу. Так теория сразу превращается в проверяемый рабочий навык.
Материал подготовил Илья Шведков. Технические источники и внутренние ссылки проверены 10 сентября 2026 года.