ТЗ на разработку ИИ-агента: готовая структура и пример
06.09.2026
Пилот ИИ-агента: план проверки, бюджет и критерии приёмки
08.09.2026ТЗ на разработку ИИ-агента: готовая структура и пример
06.09.2026Пилот ИИ-агента: план проверки, бюджет и критерии приёмки
08.09.2026
Кнопка со скрепкой ещё не означает, что нейросеть поймёт ваш файл. Один сервис извлечёт из PDF только текст и не заметит диаграмму. Другой примет видео, но проанализирует лишь расшифровку речи. Третий откроет таблицу, однако потеряет формулы, скрытые листы или связь между несколькими документами.
Если нужна нейросеть, куда можно загрузить файл, выбирайте не по длине списка расширений. Сначала ответьте, что модель должна увидеть внутри: текст, таблицы, изображения, звук, визуальный ряд видео или связи между десятками источников. Для смешанного набора фото, документов, аудио и настоящего визуального анализа видео удобнее всего начинать с Gemini. Для длинных PDF и документов — с Claude. Для проекта из десятков источников — с NotebookLM. Для аудио и видео как расшифровки — с Perplexity или GigaChat. ChatGPT полезен для документов, данных и изображений, а Алиса AI — для быстрого разбора одного документа или фото на русском.
Главное ограничение простое: конфиденциальный файл нельзя отдавать сервису только потому, что он технически принимает нужный формат. До загрузки проверьте режим обучения, срок хранения, доступ по общей ссылке и возможность удалить исходник.
Короткий ответ: куда загрузить ваш файл
| Сценарий | С чего начать | Что сервис действительно анализирует | Где остановиться и проверить |
|---|---|---|---|
| PDF, DOCX, TXT, таблица | Claude или ChatGPT | Текст, структура, данные; Claude видит иллюстрации в PDF до 100 страниц | Скан без текстового слоя, формулы, скрытые листы, сноски |
| До десяти смешанных файлов в одном запросе | Gemini | Документы, таблицы, фото, аудио и видео | Общий объём, длительность медиа, тариф и региональная доступность |
| Большая папка источников для исследования | NotebookLM | До 50 источников на бесплатном уровне: документы, сайты, аудио, изображения, YouTube-транскрипты | Сайт импортируется как текст, YouTube — как субтитры, а не видеоряд |
| Фото, скриншот, чек или схема | Gemini, Claude, ChatGPT, Алиса AI или GigaChat | Пиксели изображения и видимый текст | Мелкий шрифт, обрезанные края, рукопись, персональные данные |
| Аудиозапись или голосовое сообщение | Perplexity или GigaChat | Расшифровка речи; Perplexity добавляет поиск по транскрипту | Музыка, шум, несколько голосов, таймкоды и требования к хранению |
| Видео как визуальная сцена | Gemini | Кадры и звук в пределах текущих лимитов | Не подменяйте визуальный анализ одной расшифровкой |
| Видео как интервью или лекция | Perplexity, NotebookLM или GigaChat через аудио | Речь и содержание транскрипта | События без слов модель может не увидеть |
| Один документ или фото на русском без сложного проекта | Алиса AI | DOC, DOCX, PDF, TXT или одно изображение | Один файл на сообщение; видео как отдельный анализ не заявлено |
Это не рейтинг «кто умнее». Таблица показывает соответствие канала задаче по официально заявленным возможностям на 7 сентября 2026 года. Лимиты меняются чаще, чем качество базовой модели, поэтому перед большим проектом откройте справку своего тарифа.
Принять файл и понять файл — разные вещи
У загрузки есть как минимум пять уровней.
- Передача. Интерфейс принял файл и не показал ошибку.
- Извлечение. Сервис достал текст, таблицы, изображения или звуковую дорожку.
- Разметка. Модель сохранила страницы, листы, временные отрезки и порядок блоков.
- Понимание. Она связала подпись с диаграммой, вопрос с приложением, а реплику — с говорящим.
- Доказуемость. Ответ указывает страницу, цитату, ячейку или таймкод, по которым человек может его проверить.
Сбой на любом уровне выглядит как уверенный, но неполный ответ. Например, нейросеть прочитала текст годового отчёта, но пропустила столбчатую диаграмму, на которой и находилось главное исключение. Или получила MP4, извлекла речь и ответила на вопросы по интервью, но не заметила, что на экране показали другой продукт.
Поэтому первый контрольный вопрос после загрузки должен быть не «перескажи файл», а такой:
Перечисли, какие элементы файла ты реально смог обработать:
текст, таблицы, изображения, формулы, аудио и видеоряд.
Для каждого элемента укажи границу уверенности и то,
что могло не попасть в контекст. Пока не делай выводов.
Ответ модели не заменяет проверку документации, но быстро показывает, считает ли она видео набором кадров или только транскриптом.
Сравнение нейросетей по форматам и лимитам
Gemini: самый широкий маршрут для смешанных файлов
В приложениях Gemini можно добавлять документы, таблицы, изображения, видео, аудио, папку с кодом и репозиторий GitHub. В один запрос официально разрешено прикрепить до десяти поддерживаемых файлов. Для видео заявлено до 2 ГБ на файл, для других типов — до 100 МБ. Общая длительность видео зависит от тарифа: до пяти минут без Google AI Pro или Ultra и до часа на платных уровнях. Для аудио — до десяти минут без подписки и до трёх часов на платных уровнях.
Это делает Gemini первым кандидатом, когда в одной задаче есть PDF, фотография дефекта и короткий ролик. Но большое контекстное окно не гарантирует равномерного внимания. Google прямо предупреждает: в слишком крупной загрузке модель может не заметить детали или связи. Актуальные числа лучше сверять в официальной справке Gemini по загрузке файлов.
Практический приём: не отправляйте десять файлов с просьбой «разберись». Дайте каждому роль: договор, приложение с тарифами, фото дефекта, видео осмотра. Затем попросите таблицу противоречий с указанием источника для каждой строки.
Claude: сильный выбор для длинных PDF и документов
Claude принимает PDF, DOCX, CSV, TXT, HTML, ODT, RTF, EPUB, JSON и XLSX, а также JPEG, PNG, GIF и WebP. В обычный чат можно загрузить до 20 файлов размером до 500 МБ каждый; для PDF указан предел 1000 страниц. Но важная сноска сильнее крупной цифры: визуальные элементы PDF анализируются только в первых 100 страницах. На страницах 101–1000 Claude извлекает текст. В непохожих на PDF документах встроенные картинки также не интерпретируются.
Если отчёт на 300 страниц содержит графики в приложении, конвертация всего файла в PDF не решит задачу. Отправьте страницы с визуальными доказательствами отдельным коротким PDF или изображениями. У XLSX есть ещё одно условие: обработка требует включённой функции выполнения кода и создания файлов. Ограничения собраны в официальной инструкции Claude по загрузкам.
Claude удобно использовать для договоров, отчётов и сравнительного чтения нескольких версий. Просите не «найти риски», а составить реестр: фрагмент, страница, тип риска, почему это риск, что нужно проверить человеку.
NotebookLM: когда файлов много и важны ссылки на источники
NotebookLM — не просто чат со скрепкой, а рабочая тетрадь вокруг набора источников. Она принимает PDF, DOCX, TXT, Markdown, CSV, PPTX, EPUB, Google Docs, Slides и Sheets, изображения, аудио, веб-страницы, вставленный текст и публичные YouTube-видео с субтитрами. Один источник может содержать до 500 000 слов или занимать до 200 МБ; на бесплатном уровне доступно до 50 источников в блокноте.
Здесь особенно важны границы импорта. Веб-страница превращается в её текст, без встроенных видео и вложенных страниц. Из YouTube импортируется транскрипт, а не визуальный ряд. Google Slides ограничены 100 слайдами, Sheets — 100 000 токенов. Полный перечень и оговорки есть в справке NotebookLM по типам источников.
NotebookLM стоит выбирать для исследования, регламентов, лекционного курса или проекта, где ответ должен опираться на загруженную библиотеку. Если вопрос зависит от цвета упаковки в ролике или жеста спикера, исходное видео нужно анализировать отдельно.
Perplexity: аудио и видео как транскрипт плюс поиск
Perplexity загружает текстовые документы, код, PDF, изображения, аудио и видео. Для всех типов официально указан предел 40 МБ. Аудио и видео автоматически расшифровываются; транскрипт становится доступен для поиска, а говорящие могут быть разделены. Но визуальные сцены видеозаписи не индексируются.
Это отличный маршрут для интервью, встречи или лекции, где содержание живёт в речи. Для записи экрана, обзора интерфейса или ролика без диктора — неверный: сервис может точно пересказать слова и пропустить само действие. Ограничения прямо описаны в справке Perplexity по файлам.
Не путайте веб-источники с доказательствами из файла. В промпте разделите два слоя: сначала факты только из загрузки с таймкодами, затем отдельный блок с внешней проверкой и ссылками.
ChatGPT: документы, изображения и анализ данных
ChatGPT подходит, когда нужно не только прочитать документ или изображение, но и продолжить работу: почистить данные, собрать таблицу, черновик, презентацию или другой результат. Официальные материалы OpenAI описывают работу с загруженными файлами, данными, изображениями и PDF. В API файлы и изображения могут выступать самостоятельным вводом для извлечения, классификации и анализа визуальных элементов.
Я намеренно не указываю здесь универсальное число мегабайт: фактические ограничения потребительского интерфейса зависят от плана, режима и текущего продукта. Их нужно смотреть рядом с кнопкой загрузки в вашем аккаунте. И не считайте обычную загрузку MP4 подтверждённым визуальным анализом видео: для воспроизводимой работы извлеките кадры и транскрипт, если интерфейс явно не сообщает обратное. Для знакомства с файловыми сценариями используйте официальный учебный портал ChatGPT, а для автоматизации — быстрый старт OpenAI API.
Если основная задача — писать и сверять длинные материалы, отдельное сравнение собрано в статье про нейросети для текстов и документов.
Алиса AI: один документ или фото на русском
В чат Алисы AI можно отправить один DOC, DOCX, PDF или TXT размером до 100 МБ за сообщение, либо одно изображение до 20 МБ. Файл остаётся в чате и синхронизируется между устройствами; отдельные вложения и все файлы можно удалять через интерфейс или команду. Без Алисы Про часть функций может временно становиться недоступной из-за нагрузки.
Это удобный короткий путь для резюме документа, объяснения таблицы в PDF, вопроса по фотографии или скриншоту. Но официальная страница загрузок не обещает полноценный анализ видеоряда и не описывает одновременную работу с набором разнородных вложений. Не превращайте «умеет оживить фото» в вывод «понимает любой MP4». Форматы и ограничения проверяются в справке Алисы AI по файлам.
GigaChat: документы, изображения и русское аудио
GigaChat работает с DOCX, PDF и TXT, понимает изображения и умеет расшифровывать загруженное аудио или голосовое сообщение. Для аудио заявлено до 60 минут и 30 МБ, но без SRT и таймкодов. Для документов официальные страницы приводят более тесные границы: TXT до 1 МБ, PDF до 20 МБ или первых 50 страниц. JPEG, PNG, WebP и ряд других форматов изображений принимаются до 15 МБ.
Страницы справки GigaChat обновляются не синхронно, поэтому интерфейс перед загрузкой — финальный контроль. Большой PDF лучше заранее разделить на смысловые части, а для аудио с двумя спикерами проверить расшифровку по исходнику. Основные возможности описаны в инструкциях по документам, изображениям и расшифровке аудио.
Фото и сканы: сначала проверьте качество входа
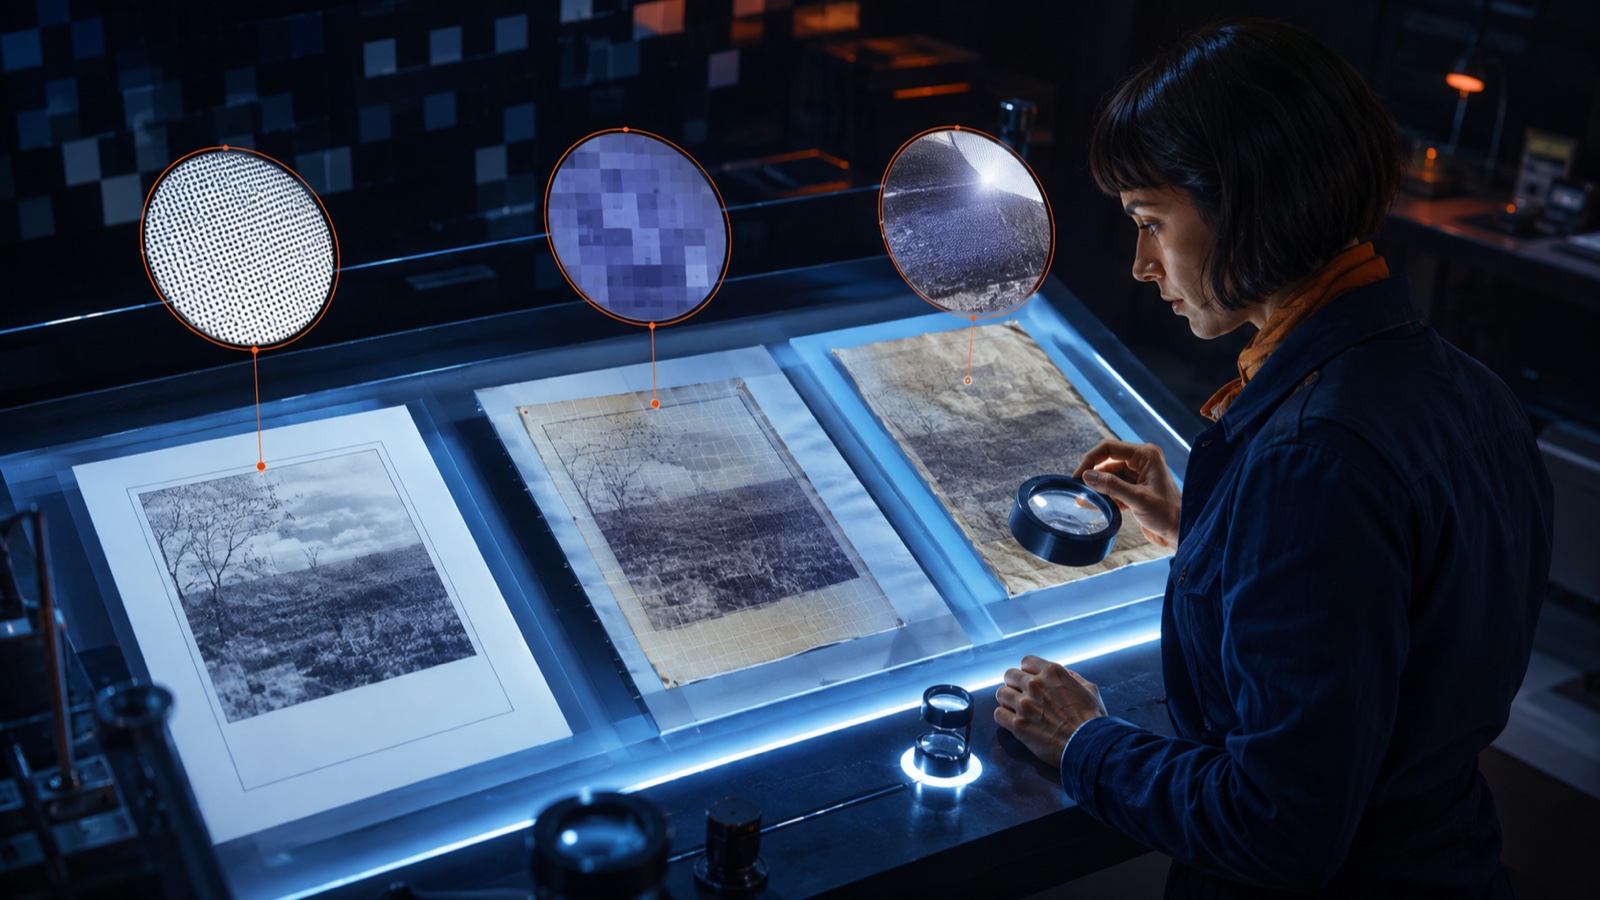
Нейросеть, которой можно отправлять фото, обычно умеет распознать видимый текст, перечислить объекты и объяснить схему. Но четыре дефекта входа превращают анализ в угадывание: низкое разрешение, блики, сильная перспектива и обрезанные края.
Перед отправкой документа с камеры:
- положите лист ровно и снимите перпендикулярно;
- уберите блики и тени от телефона;
- убедитесь, что видны номер страницы, подписи и поля;
- для мелкой таблицы сделайте общий кадр и несколько фрагментов;
- закройте паспортные данные, адреса, QR-коды и подписи, если они не нужны для ответа;
- попросите модель процитировать распознанную строку до её интерпретации.
Если нужно изменить или улучшить изображение, а не извлечь из него факты, это уже другой поисковый сценарий. Для него есть отдельное руководство по нейросетям для фото.
Видео: где модель смотрит кадры, а где только слушает речь
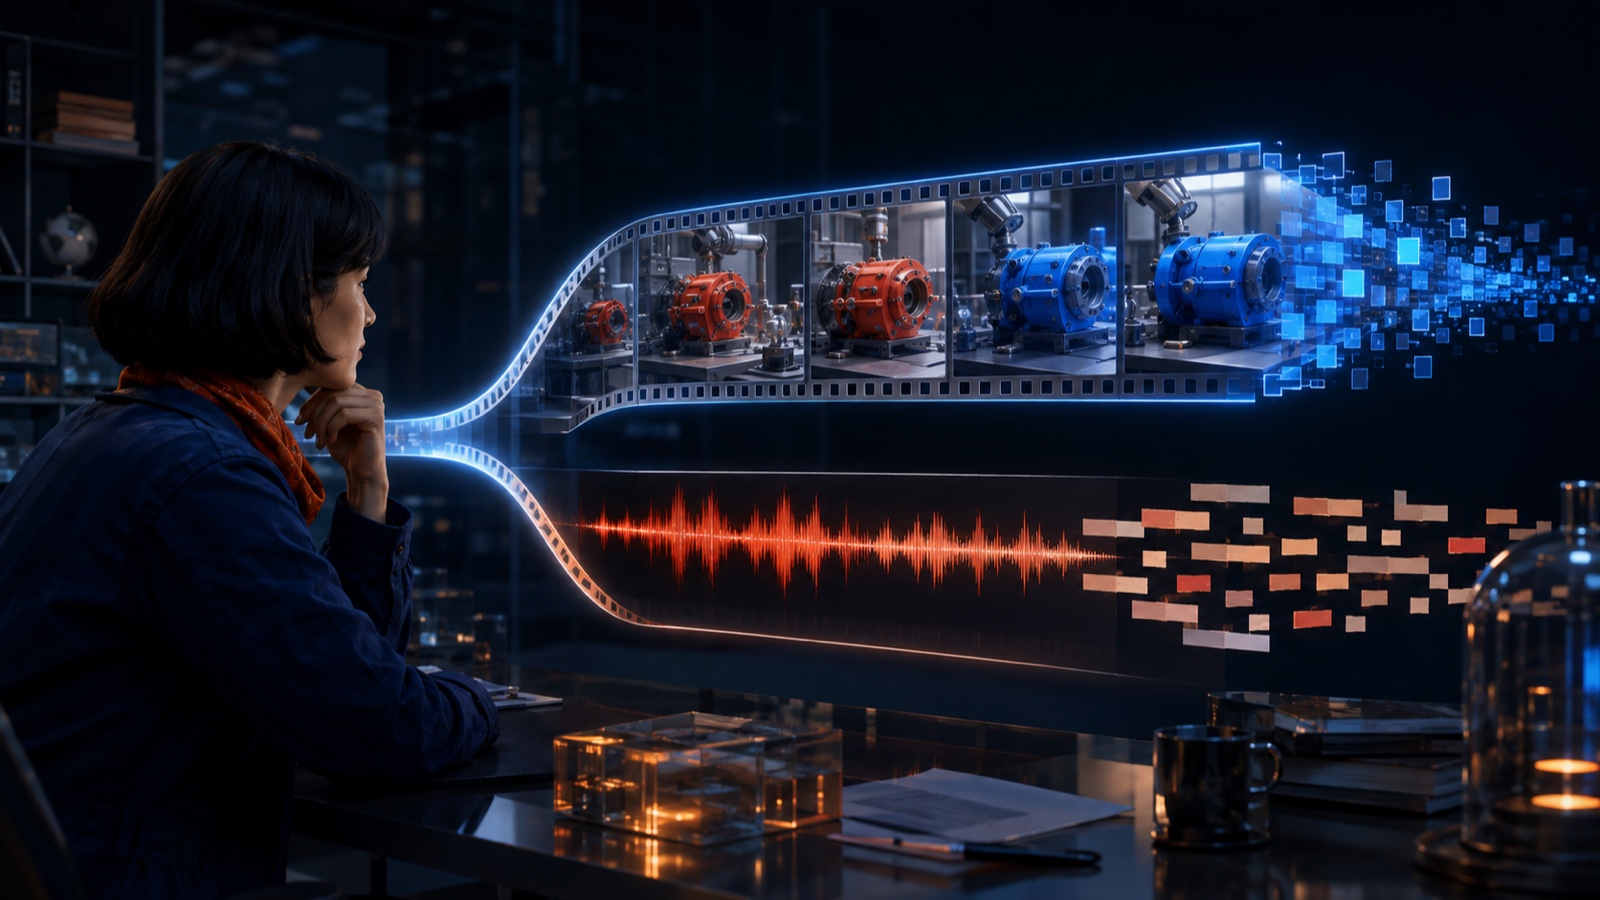
Чтобы проверить реальное понимание видео, вставьте в тест короткий визуальный факт без озвучки: человек заменяет красную деталь на синюю, на экране появляется ошибка, график резко падает. Затем спросите, что изменилось и в какой момент. Если ответ строится только на речи, перед вами транскрибация, а не анализ видеоряда.
Gemini официально заявляет работу с видео и задаёт лимит его длительности. Perplexity прямо пишет, что индексирует транскрипт, но не визуальные сцены. NotebookLM забирает из YouTube субтитры. Для ChatGPT, Алисы AI и GigaChat безопаснее готовить отдельный пакет, если интерфейс не подтверждает просмотр видео:
- транскрипт с таймкодами;
- 8–20 ключевых кадров;
- короткое описание того, что не произносится вслух;
- точные вопросы к речи и изображению отдельно.
Не загружайте часовой ролик, если нужен один момент. Обрежьте фрагмент вокруг события: так вы сокращаете стоимость, риск пропуска и время ручной проверки. А если задача состоит в генерации и монтаже, используйте обзор нейросетей для создания видео.
Воспроизводимый тест: одинаковый набор файлов для всех сервисов
Не переносите чужой рейтинг на свой архив. Соберите небольшой синтетический комплект без персональных и коммерческих данных:
- PDF на восемь страниц. Добавьте таблицу, диаграмму и намеренное противоречие между страницами 2 и 7.
- XLSX и CSV на 20 строк. Оставьте один дубль, одну пустую ячейку и одну формулу, которую можно проверить вручную.
- Фото или скан. Разместите крупный текст, мелкую сноску и одно рукописное исправление.
- MP3 на восемь минут. Два говорящих, одна оговорка и явное исправление позже.
- MP4 на 90 секунд. Одно утверждение произнесите голосом, а одно событие покажите только в кадре.
Затем задайте одинаковые вопросы. Не просите свободное резюме: оно позволяет модели выбрать удобные факты и скрыть пропуски.
1. Составь инвентаризацию всех файлов и доступных тебе слоёв данных.
2. Найди противоречия. Для каждого укажи источник, страницу, ячейку
   или таймкод. Если точной привязки нет, напиши об этом.
3. Отдельно перечисли факты из текста, таблиц, изображений, аудио
   и видеоряда. Не смешивай источники.
4. Назови элементы, которые ты не смог прочитать уверенно.
5. Не додумывай отсутствующие данные и не исправляй их молча.
Оцените результат по семи критериям: покрытие файлов, точность ссылок на источник, поиск противоречий, сохранность чисел и формул, понимание визуальных деталей, честность неопределённости и ясность правил хранения. «Красивее написал» — слабый критерий для работы с файлами.
Я не публикую выдуманную таблицу победителей: без фактического прогона на одинаковых тарифах и моделях она создавала бы ложную точность. Протокол выше позволяет получить ваш результат и повторить его после обновления сервиса.
Приватность: что проверить до загрузки
Технический лимит отвечает на вопрос «примут ли файл». Политика данных — «что произойдёт после».
У потребительских аккаунтов правила различаются. В Gemini сохранение активности по умолчанию связано с историей и улучшением сервисов; Google предлагает отключить Keep Activity или использовать временный чат. Такие диалоги всё равно хранятся до 72 часов для работы и безопасности. В Perplexity у Free, Pro и Max использование данных для улучшения моделей включено по умолчанию, но его можно отключить для будущих данных. Сессионные загрузки обычно хранятся 30 дней, а файлы проекта — до удаления. У Claude потребительские беседы используются для улучшения моделей при согласии пользователя и в отдельных явно описанных случаях; режим Incognito не попадает в историю или обучение и обычно хранится 30 дней.
Это не повод объявлять один сервис «безопасным», а другой «опасным». Корпоративные тарифы, региональные условия и политики организации могут отличаться. Перед рабочим файлом проверьте официальные страницы Gemini Privacy Hub, Perplexity о сборе данных, Perplexity о хранении загрузок, Claude об обучении и Claude Incognito.
Минимальный рабочий протокол:
- удалите поля, не влияющие на задачу;
- замените ФИО, телефоны и номера договоров метками;
- не отправляйте пароли, ключи API, платёжные данные и закрытые медицинские сведения;
- для команды используйте утверждённый корпоративный аккаунт, а не личную подписку сотрудника;
- отключите обучение или выберите временный режим, если это соответствует вашей политике;
- не создавайте общую ссылку на чат с вложениями;
- после работы удалите ненужный чат, файл и проект и зафиксируйте это в регламенте.
Как выбрать сервис за десять минут
Шаг 1. Назовите слой данных
Не «у меня видео», а «мне нужны реплики», «мне нужен момент смены детали» или «нужно связать с договором». Тип контейнера не равен задаче.
Шаг 2. Проверьте лимит до регистрации
Сравните размер, число файлов, страницы и длительность. Если исходник больше, решите, можно ли разделить его без потери смысла.
Шаг 3. Прочитайте одно критическое ограничение
Для Claude это граница визуального чтения PDF, для Perplexity — отсутствие индексации сцен видео, для NotebookLM — текстовый импорт сайтов и YouTube, для Алисы AI — один файл на сообщение.
Шаг 4. Запустите контрольный файл
Используйте один безопасный документ с заранее известной ошибкой. Если модель не находит её и не признаёт границы, не передавайте большой архив.
Шаг 5. Решите вопрос с данными
Проверьте обучение, хранение, общий доступ и удаление. Настройка после загрузки может влиять только на будущие данные.
Шаг 6. Сохраните доказуемый результат
Хороший ответ содержит источники внутри файла, а не только гладкое резюме. Для важного решения вручную откройте страницу, ячейку или таймкод.
Если выбор всё ещё распадается на десяток критериев, начните с общей матрицы нейросетей по задачам. А доступность функций и оплаты из России отдельно сверяйте по обзору работающих бесплатных нейросетей и прямо в интерфейсе перед подпиской.
Что выбрать именно вам
Нужно загрузить PDF и получить проверяемый разбор. Начните с Claude; для библиотеки связанных документов — с NotebookLM. Страницы с важными схемами вынесите в отдельный короткий файл.
Нужно вместе анализировать фото, документ и короткое видео. Начните с Gemini. Пронумеруйте вложения и просите ссылаться на каждое отдельно.
Нужно разобрать интервью, встречу или лекцию. Perplexity удобен для транскрипта и дальнейшей проверки через веб. GigaChat — практичный вариант для русскоязычного аудио в заявленных пределах. NotebookLM хорош, если запись станет одним источником в большой базе.
Нужно исследовать видеоряд, а не речь. Используйте Gemini или предварительно извлеките кадры. Не выбирайте режим, который прямо индексирует только транскрипт.
Нужно работать с файлом на русском без сложной сборки. Попробуйте Алису AI или GigaChat. Разделите большой документ и проверьте числа по оригиналу.
Нужно превратить анализ в новый документ, таблицу или презентацию. ChatGPT удобен как рабочая среда вокруг исходных данных. Пределы своего плана проверьте в интерфейсе до массовой загрузки.
Файл конфиденциальный. Сначала удалите лишние данные и получите разрешение владельца. Затем используйте корпоративный режим с подходящими договорными условиями или локальный контур. Возможность запустить модель без отправки файлов в облако разобрана в статье про локальные нейросети на компьютере.
Частые вопросы
В какую нейросеть можно загрузить PDF?
PDF принимают Gemini, Claude, ChatGPT, NotebookLM, Perplexity, Алиса AI и GigaChat. Для длинного документа удобны Claude и NotebookLM, но проверьте визуальные ограничения: Claude анализирует графику только в первых 100 страницах PDF, а скан низкого качества может потребовать отдельного OCR или загрузки страниц изображениями.
Какая нейросеть принимает несколько файлов сразу?
Gemini принимает до десяти поддерживаемых файлов в одном запросе. Claude — до 20 файлов в обычном чате. NotebookLM строит блокнот вокруг множества источников и на бесплатном уровне заявляет до 50. Практический предел всё равно задаётся общим контекстом и размером каждого файла.
Какая нейросеть понимает видео?
Gemini официально поддерживает визуальный анализ загруженного видео в пределах лимитов длительности. Perplexity расшифровывает аудиодорожку, но прямо сообщает, что не индексирует визуальные сцены. NotebookLM использует транскрипт YouTube. Для остальных сервисов безопаснее загрузить транскрипт и ключевые кадры отдельно, если интерфейс не подтверждает работу с видеорядом.
Можно ли загрузить голосовое сообщение?
Да. Perplexity принимает аудио и создаёт поисковый транскрипт. GigaChat принимает аудиофайлы и голосовые сообщения до 60 минут и 30 МБ. Gemini также поддерживает аудио, но доступная суммарная длительность зависит от тарифа.
Нейросеть видит таблицы и формулы в Excel?
Она может извлечь значения и анализировать структуру, но формула, отображаемое значение, скрытый лист и форматирование — разные слои. Для XLSX в Claude требуется включённое выполнение кода. Всегда просите перечислить листы, отличить формулы от значений и проверить результат на контрольной строке.
Безопасно ли загружать договор или паспорт?
Сам факт поддержки PDF не делает загрузку безопасной. Удалите не относящиеся к вопросу персональные данные, проверьте режим обучения и хранения, не делитесь чатом по публичной ссылке и используйте утверждённый корпоративный контур для рабочих документов. Паспорт целиком в универсальный потребительский чат лучше не отправлять.
Почему нейросеть пропускает часть большого файла?
Размер может помещаться в технический лимит, но содержание — конкурировать за внимание внутри контекста. Разделите архив по темам, дайте файлам роли, задайте вопросы по одному слою данных и потребуйте ссылки на страницу, ячейку или таймкод.
Вывод: выбирайте не скрепку, а доказуемый способ чтения
Нейросеть для файлов — это не одна функция. Gemini охватывает самый широкий смешанный набор и реально работает с видео. Claude удобен для длинных документов, NotebookLM — для библиотеки источников, Perplexity и GigaChat — для речи в аудио и видео, ChatGPT — для продолжения работы с документами и данными, Алиса AI — для быстрого русскоязычного разбора одного файла или фото.
Перед важной загрузкой проверьте три вещи: какой слой файла модель видит, на что она может сослаться и что сервис сделает с данными после ответа. Один контрольный файл с известным противоречием расскажет о пригодности инструмента больше, чем список из пятидесяти форматов.
Хотите собрать собственный файловый процесс без угадывания — от безопасной подготовки документов до проверяемого ответа и автоматизации? Посмотрите программы обучения нейросетям Ильи Шведкова. На обучение лучше принести реальный обезличенный комплект: документ, таблицу, фото и запись. Тогда выбор сервиса сразу превращается в рабочий регламент.
Материал подготовил Илья Шведков. Возможности, лимиты и правила данных проверены 7 сентября 2026 года.