Опрос после поста — не вовлечение ради вовлечения: как превратить ответ в следующую тему
04.09.2026
Почему полезный пост не ведёт к диалогу: разбираем переход от пользы к CTA
05.09.2026Опрос после поста — не вовлечение ради вовлечения: как превратить ответ в следующую тему
04.09.2026Почему полезный пост не ведёт к диалогу: разбираем переход от пользы к CTA
05.09.2026
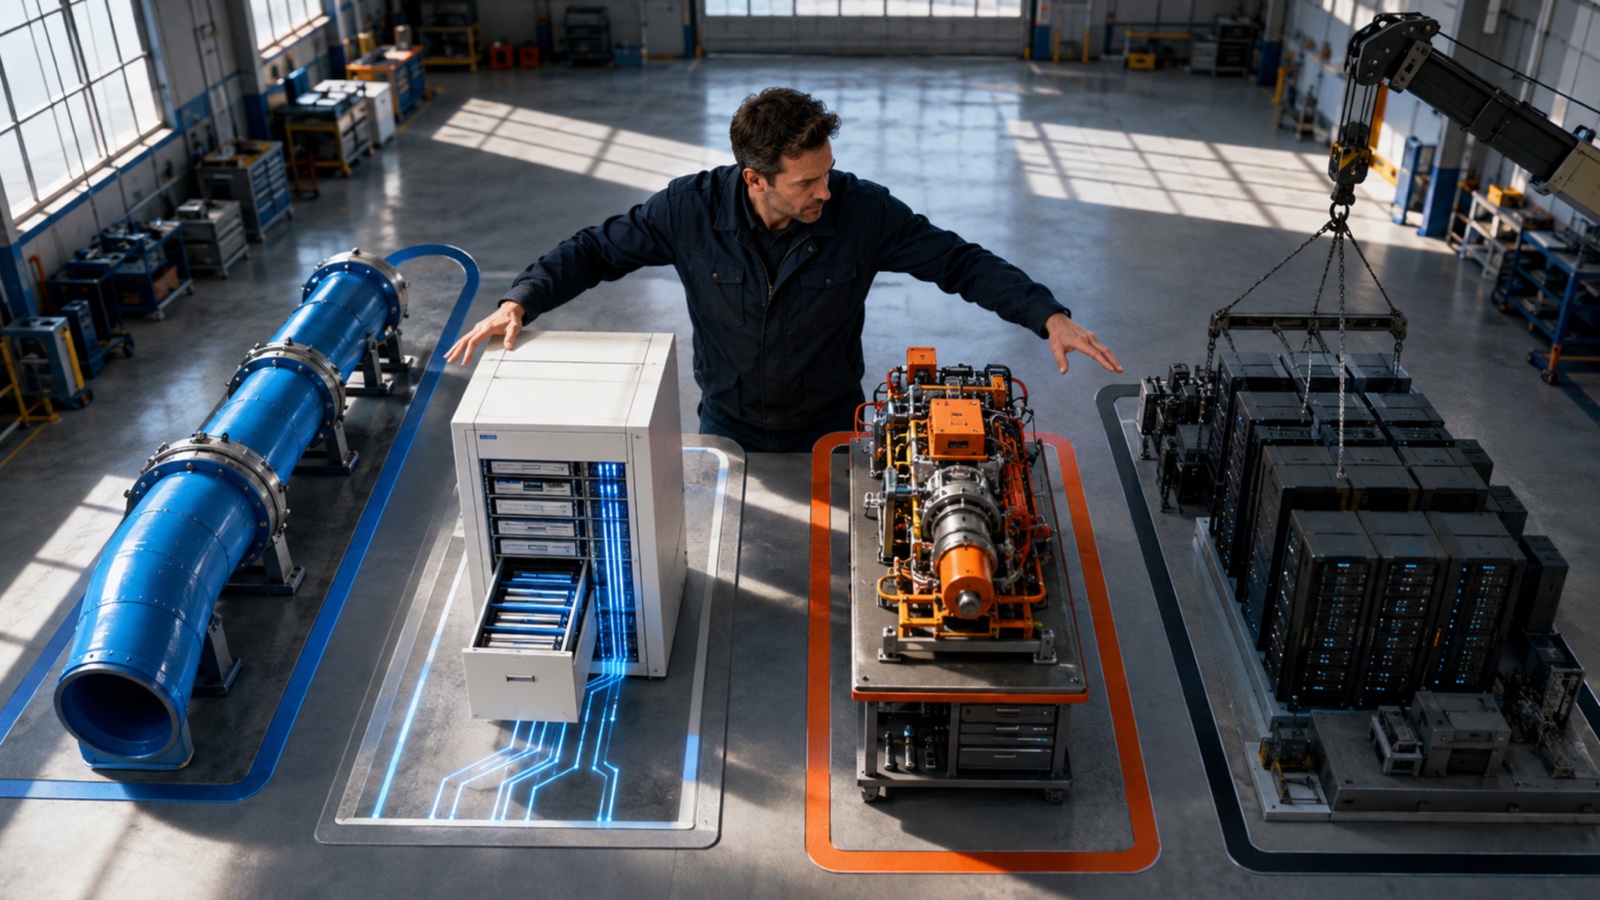
Фраза «хочу свою нейросеть» звучит как один проект. На деле за ней прячутся четыре разных заказа: подключить готовую модель по API, научить её отвечать по документам компании через RAG, дообучить открытую модель или построить модель с нуля. Между первым и последним вариантом — не проценты, а несколько порядков бюджета.
Короткий ответ: рабочий AI-сервис на готовом API можно собрать примерно за 420–742 тыс. ₽, RAG-систему для внутренних знаний — за 700 тыс.–1,44 млн ₽, а проект с дообучением открытой модели — ориентировочно за 1,5–3,5 млн ₽. Это не прайс агентства и не обещание результата. Это три воспроизводимые сметы: часы умножены на условную внутреннюю ставку 3500 ₽, а вычисления посчитаны отдельно по открытым тарифам.
Мой вердикт простой: большинству компаний не нужно обучать нейросеть. Им нужно аккуратно собрать систему вокруг уже обученной модели — с данными, проверкой качества, правами доступа и интеграцией. Слово «обучение» в коммерческом предложении часто выглядит солиднее, но деньги за солидность модель не возвращает.
Короткий ответ: сколько стоит создать нейросеть
| Подход | Ориентир первого запуска | Ежемесячные расходы после запуска | Когда выбирать |
|---|---|---|---|
| Приложение на готовом API | 420–742 тыс. ₽ | пример: 18–100 тыс. ₽ с 4–20 часами поддержки | Нужны генерация, анализ, классификация или помощник без собственных знаний модели |
| RAG по документам компании | 700 тыс.–1,44 млн ₽ | пример: 20–100 тыс. ₽ с API, хранением и 4–20 часами поддержки | Ответ должен опираться на актуальные регламенты, базу знаний или каталог |
| Дообучение открытой модели | 1,5–3,5 млн ₽ | примерно 50–160 тыс. ₽ только за выделенный GPU плюс эксплуатация | Промпты и RAG не дают устойчивого формата, стиля или поведения |
| Языковая модель с нуля | от сотен миллионов рублей только на вычислительный эквивалент | отдельная большая инфраструктура и команда | Есть уникальные данные, исследовательская задача и масштаб, который оправдывает собственную базовую модель |
Диапазоны относятся к MVP, который можно показать пользователям и измерить, а не к демонстрации в ноутбуке разработчика. Внутренняя ставка 3500 ₽ в час — условие расчёта, а не рыночная статистика. Месячные примеры в первых двух строках включают 4–20 часов поддержки по той же ставке и условные 4–30 тыс. ₽ на сервисы. Подставьте ставку своей команды, реальный тариф провайдера и нагрузку — получите собственную смету.
Если вам нужен не проект разработки, а цена готовых чатов и генераторов, откройте отдельный разбор стоимости подписок на нейросети в 2026 году. Здесь считаем именно создание бизнес-системы.
Что заказчик обычно называет «своей нейросетью»
1. Готовая модель через API
Вы не создаёте базовую нейросеть. Вы строите продукт: форму, бота, личный кабинет или автоматический процесс, который отправляет запросы провайдеру и получает ответы. Ценность возникает в сценарии, интеграции и контроле качества.
Пример: входящие обращения распределяются по теме и срочности, менеджеру предлагается черновик ответа, а итог записывается в CRM. Модель уже умеет работать с текстом. Команда настраивает процесс вокруг неё.
2. RAG: модель отвечает по вашим документам
RAG — это поиск нужных фрагментов в корпоративной базе и передача их модели вместе с вопросом. Вес модели при этом не меняется. Обновили регламент — переиндексировали документ, а не запустили новое обучение.
Такой подход нужен, когда ответ зависит от меняющихся фактов: цен, инструкций, договоров, каталога, базы поддержки. Правильный вопрос здесь не «как обучить нейросеть на PDF», а «как модель найдёт доказательство, покажет источник и не увидит чужой документ».
3. Дообучение готовой модели
Модель дополнительно обучают на примерах нужных входов и ответов. Цель — не загрузить в неё справочник компании, а изменить устойчивое поведение: формат, стиль, классификацию, следование специализированной инструкции.
Для открытых моделей часто используют PEFT и LoRA. В официальной документации Hugging Face объясняется, что базовые веса можно заморозить и обучать небольшие низкоранговые матрицы. Это снижает число обучаемых параметров и требования к памяти, но не отменяет датасет, эксперименты и оценку качества.
4. Обучение базовой модели с нуля
Вы выбираете архитектуру, готовите огромный корпус, запускаете предобучение, оцениваете модель, исправляете данные и повторяете. Для небольшой модели прогнозирования спроса это может быть обычный ML-проект. Для современной генеративной языковой модели — отдельная исследовательская программа.
Вот где полезно остановиться. Если подрядчик обещает «свою нейросеть» за 300 тыс. ₽, он почти наверняка имеет в виду приложение на готовой модели, RAG или дообучение компактной модели. Это нормально. Ненормально называть одно другим.
Как я собрал три сметы
Сметы ниже можно повторить. Я не выдаю их за завершённые клиентские проекты и не приписываю Илье опыт, которого нет в исходных материалах.
Формула первого запуска:
Стоимость запуска = часы команды × внутренняя ставка
                   + данные и разметка
                   + вычислительные эксперименты
                   + интеграции и безопасность
                   + резерв на неопределённость
В таблицах резерв не спрятан отдельной строкой: диапазон часов уже учитывает один-два цикла исправлений. Если требования не определены, данные не собраны или согласование идёт через пять подразделений, добавляйте 20–40% сверху. Это не «жадность разработчиков», а цена неизвестности.
Ежемесячная стоимость владения считается иначе:
TCO в месяц = API или GPU
              + серверы, хранение и мониторинг
              + поддержка и разбор ошибок
              + регулярная переоценка качества
              + обновление данных и интеграций
Я использую условную ставку 3500 ₽/час для всей смешанной команды. В реальном проекте аналитик, ML-инженер, backend-разработчик, специалист по безопасности и руководитель проекта стоят по-разному. Одна ставка здесь нужна только для понятной арифметики.
Смета №1. AI-сервис на готовом API — 420–742 тыс. ₽
Представим внутреннего помощника: сотрудник отправляет запрос, сервис применяет системные правила, вызывает готовую модель, проверяет формат ответа и сохраняет результат в рабочую систему. Собственных документов в контекст пока не добавляем.
| Работа | Часы, минимум | Часы, верхняя граница | Что должно получиться |
|---|---|---|---|
| Разбор процесса и критериев успеха | 12 | 20 | Одна задача, владельцы, ограничения, цена ошибки |
| Промпты и набор проверочных примеров | 24 | 40 | Версионируемые инструкции и 30–50 контрольных запросов |
| Backend и интеграция | 40 | 80 | Авторизация, запросы к модели, запись результата, обработка ошибок |
| Безопасность, логи и лимиты | 24 | 40 | Маскирование данных, журнал событий, квоты, таймауты |
| QA, управление и запуск | 20 | 32 | Приёмка, инструкция, метрики и контролируемый релиз |
| Итого | 120 | 212 | MVP в рабочем контуре |
Расчёт:
120 часов × 3500 ₽ = 420 000 ₽
212 часов × 3500 ₽ = 742 000 ₽
Плата провайдеру на старте часто теряется на фоне разработки. Например, у действующих корпоративных клиентов GigaChat синхронный режим Pro в тарифах для юрлиц от 2 сентября 2026 года стоит 0,5 ₽ за 1000 токенов с НДС. Десять миллионов токенов дали бы 5000 ₽. Но для новых клиентов с 1 сентября оплата перенесена на Cloud.ru, поэтому перед бюджетированием нужно смотреть условия именно там.
У зарубежного API арифметика может быть ещё нагляднее. По текущей странице цен OpenAI API модель GPT‑5.6 Luna стоит $0,20 за миллион входных и $1,20 за миллион выходных токенов в стандартном режиме. Десять миллионов входных и два миллиона выходных токенов — $4,40, или около 381 ₽ по официальному курсу ЦБ на 5 сентября. Инструменты, хранение и разработка оплачиваются отдельно.
Это не рекомендация конкретного поставщика. России нет в официальном списке поддерживаемых OpenAI стран, а работа из неподдерживаемой территории может нарушать условия сервиса. Российскому бизнесу нужен провайдер и платёжный маршрут, законно доступные его организации.
Когда смета вырастет
- требуется обработка персональных, медицинских, финансовых или коммерчески чувствительных данных;
- ответ автоматически запускает действие, которое нельзя легко отменить;
- интеграция идёт со старой CRM без стабильного API;
- нужны голос, изображения, сложные агенты или несколько провайдеров;
- компания требует отказоустойчивость, отдельные среды и аудит безопасности.
Перед разработкой полезно пройти чек-лист готовности процесса к автоматизации. Плохой процесс нейросеть не чинит. Она просто выполняет его ошибки быстрее.
Смета №2. RAG по базе знаний — 700 тыс.–1,44 млн ₽
Допустим, помощник должен отвечать по 10–50 тысячам страниц инструкций, договоров и продуктовой документации. Пользователь видит цитату и ссылку на источник, а права доступа наследуются из корпоративной системы.
| Работа | Часы, минимум | Часы, верхняя граница | Что должно получиться |
|---|---|---|---|
| Аудит документов и прав | 24 | 60 | Перечень источников, владельцы, сроки обновления, ACL |
| Загрузка, очистка и разбиение | 40 | 80 | Повторяемый конвейер индексации и удаление дублей |
| Поиск, ранжирование и набор оценок | 40 | 80 | Тестовые вопросы, релевантность фрагментов, порог отказа |
| Интерфейс и интеграция | 40 | 80 | Рабочий канал, ссылки на источники, обратная связь |
| Безопасность и наблюдаемость | 32 | 64 | Изоляция данных, логи, мониторинг качества и стоимости |
| QA, управление и запуск | 24 | 48 | Приёмка по ролям, инструкция, план обновлений |
| Итого | 200 | 412 | RAG-MVP с проверяемыми ответами |
Расчёт:
200 часов × 3500 ₽ = 700 000 ₽
412 часов × 3500 ₽ = 1 442 000 ₽
Само создание эмбеддингов обычно не главная статья. В действующем тарифе GigaChat для юрлиц синхронный endpoint embeddings стоит 0,014 ₽ за 1000 токенов: 20 млн токенов — 280 ₽. На OpenAI text-embedding-3-large стоит $0,13 за миллион входных токенов, а text-embedding-3-small — $0,02. Но к этому добавляются генерация ответа, хранение векторов, поисковые вызовы, сервер, мониторинг и поддержка.
Официальное руководство OpenAI по retrieval хорошо показывает механику: vector store автоматически разбивает, векторизует и индексирует файлы. У управляемого File Search хранение сверх первого бесплатного гигабайта стоит $0,10 за ГБ в день, а вызовы инструмента — $2,50 за тысячу. Двадцать занятых гигабайт — это 19 платных × $0,10 × 30, то есть $57 в месяц только за хранение.
На практике бюджет RAG съедает не векторная база, а порядок в документах. Если три отдела хранят разные версии инструкции, поиск честно найдёт все три. Модель не знает, какая версия утверждена вчера директором.
Что принимать у подрядчика
Не принимайте RAG по фразе «ответ выглядит разумно». Нужен набор вопросов с ожидаемыми источниками и четыре отдельные метрики:
- найден ли правильный документ;
- найден ли правильный фрагмент;
- соответствует ли ответ найденному фрагменту;
- отказалась ли система отвечать, когда доказательства нет.
Добавьте тесты прав доступа. Запрос сотрудника отдела продаж не должен вытаскивать фрагмент из закрытой папки HR даже тогда, когда смысл подходит идеально.
Смета №3. Дообучение открытой модели — 1,5–3,5 млн ₽
Сценарий: компании нужна модель, которая стабильно превращает свободный текст в строгую структуру, соблюдает отраслевую терминологию и работает в собственном контуре. Промпт помогает, RAG добавляет факты, но формат всё ещё «плывёт». Тогда дообучение можно защищать цифрами.
| Работа | Часы, минимум | Часы, верхняя граница | Что должно получиться |
|---|---|---|---|
| Формализация задачи и eval-набор | 40 | 80 | Базовая метрика до обучения и закрытая проверочная выборка |
| Сбор, очистка и разметка примеров | 120 | 300 | Версионируемый датасет с правилами и контролем качества |
| Обучающий конвейер | 40 | 80 | Воспроизводимая конфигурация, LoRA/PEFT, сохранение артефактов |
| Серия экспериментов | 80 | 200 | Сравнение базовой и обученных версий без утечки тестовых данных |
| Развёртывание | 40 | 80 | Endpoint, масштабирование, квоты и откат версии |
| Безопасность, мониторинг и запуск | 40 | 80 | Логи, контроль деградации, документация и приёмка |
| Итого | 360 | 820 | Версия модели, которую можно сравнить с базовой |
Труд команды:
360 часов × 3500 ₽ = 1 260 000 ₽
820 часов × 3500 ₽ = 2 870 000 ₽
Добавим вычислительный пример. AWS сейчас показывает для Capacity Blocks в США цену $5,191 за H100-час. Один эксперимент на восьми H100 длительностью 20 часов:
8 GPU × 20 часов × $5,191 = $830,56
$830,56 × 86,5857 ₽/$ = 71 915 ₽
Три таких запуска — около 216 тыс. ₽, восемь — около 575 тыс. ₽. Получаем ориентир 1,48–3,45 млн ₽, который разумно округлить до 1,5–3,5 млн ₽. Тариф H100 взят с официальной страницы AWS Capacity Blocks, курс 86,5857 ₽/$ — из курсов Банка России на 5 сентября 2026 года.
Это специально консервативная иллюстрация дорогого эксперимента, а не минимальное требование LoRA. Компактную модель можно дообучить на одной более дешёвой GPU. Цена зависит от числа параметров, длины последовательности, размера батча, точности вычислений и объёма данных.
После запуска появляется постоянный GPU-счёт. В официальной таблице Hugging Face Inference Endpoints на AWS L4 стоит $0,80/час, A100 — $2,50/час. При непрерывной работе 730 часов это $584 и $1825, то есть примерно 50,6 тыс. и 158 тыс. ₽ в месяц по тому же курсу. Резервирование, автомасштабирование и паузы меняют итог.
Сначала докажите, что дообучение нужно
Дообучение должно выигрывать у базовой модели на закрытом наборе примеров. Если нет исходной метрики, фраза «стало лучше» ничего не значит.
В руководстве OpenAI по supervised fine-tuning рекомендуют сначала настроить evals и начать примерно с 50 качественных демонстраций; улучшения часто видны в диапазоне 50–100 примеров. Сам совет полезен для любого провайдера. Но важна свежая оговорка: на странице цен OpenAI сказано, что платформа fine-tuning сворачивается и больше не доступна новым пользователям. Поэтому новый проект нельзя планировать так, будто этот маршрут гарантированно открыт.
Почему «обучить на документах» чаще означает RAG
Если модель должна знать актуальную цену товара, новый пункт договора или сегодняшнюю инструкцию, дообучение — плохое хранилище. Оно не даёт простой гарантии, что конкретный факт запомнен, не показывает источник и требует повторного цикла при обновлении.
RAG выигрывает, когда:
- факты часто меняются;
- ответ должен ссылаться на документ;
- разным ролям доступны разные источники;
- важна возможность быстро удалить данные;
- необходимо видеть, что именно использовала модель.
Дообучение выигрывает, когда:
- нужен устойчивый формат вывода;
- модель повторяет одну и ту же поведенческую ошибку;
- есть сотни качественных примеров правильной реакции;
- выигрыш измеряется на закрытом наборе;
- промпт стал слишком длинным и всё равно не удерживает поведение.
Часто сильная система использует оба подхода: LoRA задаёт поведение, RAG приносит свежие факты. Но начинать стоит с самого дешёвого уровня, который проходит приёмку: промпт, затем RAG, и только потом дообучение.
Сколько стоит обучить языковую модель с нуля
Для реального масштаба возьмём открытые данные Meta. В официальной карточке Llama 3.1 указано: 8B-модель потребовала 1,46 млн H100 GPU-часов, 70B — 7 млн, 405B — 30,84 млн. Семейство обучалось более чем на 15 трлн токенов.
Умножим часы на текущий открытый тариф AWS $5,191 за H100-час и затем на курс ЦБ 86,5857 ₽/$:
| Модель | H100 GPU-часы Meta | Условный эквивалент аренды | В рублях по курсу ЦБ |
|---|---|---|---|
| Llama 3.1 8B | 1 460 000 | $7 578 860 | около 656 млн ₽ |
| Llama 3.1 70B | 7 000 000 | $36 337 000 | около 3,15 млрд ₽ |
| Llama 3.1 405B | 30 840 000 | $160 090 440 | около 13,86 млрд ₽ |
Это не расходы Meta и не коммерческое предложение AWS. Meta могла владеть оборудованием, получать другие условия и использовать другую внутреннюю себестоимость. Расчёт — понятная линейка масштаба. В нём нет команды, сбора и фильтрации данных, неудачных запусков, хранения, сети, evals, безопасности и обслуживания кластера.
Отсюда не следует, что любое обучение с нуля стоит сотни миллионов. Небольшую модель классификации, прогнозирования или компьютерного зрения можно обучить на имеющихся данных и одной машине. Но запрос «сделать собственный аналог современной универсальной LLM» начинается в совсем другой экономике.
Если задача — работать локально, сначала изучите варианты запуска нейросети на своём компьютере. Важно: скачать и запустить открытую модель — не то же самое, что обучить её с нуля.
Семь расходов, которые забывают в первой смете
1. Подготовка данных
Документы приходится очищать, удалять дубли, связывать с владельцами и сроками действия. Для дообучения нужны пары «вход — правильный ответ», правила разметки и контроль согласованности. Пять тысяч плохих примеров могут быть хуже пятидесяти тщательно отобранных.
2. Набор оценок
Проверочные вопросы — отдельный продукт. Их нельзя полностью создавать той же моделью и сразу считать истиной. Нужны реальные классы задач, пограничные случаи, запрещённые ответы и критерии отказа.
3. Интеграция
Демо принимает текст и возвращает текст. Рабочая система знает пользователя, его роль, карточку клиента, историю операции и место, куда сохранить результат. Именно здесь часто появляются самые дорогие часы.
4. Безопасность и юридические требования
Нужно решить, какие данные уходят провайдеру, сколько они хранятся, кто видит логи, как удалить информацию и что произойдёт при утечке. По официальной политике данных OpenAI API данные API по умолчанию не используются для обучения моделей без явного согласия, но журналы мониторинга злоупотреблений могут храниться до 30 дней, а сроки отдельных endpoint различаются. У другого провайдера будут свои условия.
5. Наблюдаемость
Нужно видеть стоимость запроса, задержку, отказ провайдера, выбранную версию модели, использованные источники и оценку пользователя. Без этого команда узнаёт о деградации от раздражённого клиента.
6. Человек в контуре
Если цена ошибки высока, ответ проверяет сотрудник. Его время входит в TCO. Автоматизация, которая сэкономила две минуты генерации и добавила десять минут проверки, не окупилась.
7. Изменения после запуска
Провайдер обновляет модель, документы устаревают, сотрудники меняют процесс, лимиты и тарифы пересматриваются. Заложите владельца системы и ежемесячный цикл оценки. «Запустили и забыли» — не режим эксплуатации.
Как получить свою смету за семь рабочих дней
Не начинайте с технического задания на 80 страниц. Начните с короткого доказательства экономики.
- День 1: назовите одно решение системы. Например, «определить тему обращения и предложить черновик ответа». Не «внедрить AI в поддержку».
- День 2: соберите 30–50 обезличенных примеров. Разделите их на разработку и закрытую проверку.
- День 3: измерьте текущий процесс. Время, стоимость, доля ошибок, число возвратов и цена промаха.
- День 4: проверьте готовую модель без разработки. Ручной прототип покажет, решается ли задача промптом.
- День 5: добавьте поиск по нескольким источникам. Если факты меняются, проверьте RAG до дообучения.
- День 6: посчитайте нагрузку. Пользователи × операций × токены, пиковые часы, срок хранения и нужная доступность.
- День 7: соберите диапазон. Оптимистичный, рабочий и стрессовый сценарии с одинаковыми допущениями.
Для более широкого плана используйте девять этапов внедрения ИИ в бизнес. Там техническая сборка стоит после выбора процесса, метрик и владельца — именно в таком порядке проект реже превращается в дорогой эксперимент без заказчика.
Дерево решения: API, RAG, дообучение или модель с нуля
Нужно решать задачу, которую готовая модель уже умеет?
├─ Да → Нужны актуальные факты из ваших документов?
│       ├─ Нет → API-приложение
│       └─ Да  → RAG
│                └─ Формат или поведение всё ещё нестабильны?
│                   ├─ Нет → Остановиться на RAG
│                   └─ Да  → Проверить дообучение на eval-наборе
└─ Нет → Есть уникальный датасет и доказательство, что готовые модели не подходят?
        ├─ Нет → Переформулировать задачу или выбрать другую готовую модель
        └─ Да  → Оценить специализированную модель; базовую LLM с нуля — только при соответствующем масштабе
Не выбирайте архитектуру по престижу. Выбирайте самую простую, которая выполняет критерий приёмки. Если две системы дают одинаковое качество, побеждает та, которую дешевле объяснить, проверить, отключить и заменить.
Если вы ещё сравниваете сами модели, а не архитектуру, начните с материала какая нейросеть лучше для разных задач. Слабую базовую модель интеграция не превратит в сильную.
Что спросить у подрядчика до договора
Хорошее предложение отвечает не только на вопрос «сколько», но и на вопрос «за что».
- Какой из четырёх подходов фактически используется?
- Где заканчивается готовая модель и начинается разработка подрядчика?
- Какие данные нужны, кто их очищает и кому принадлежат результаты разметки?
- На каком наборе измеряется качество до и после запуска?
- Как система отказывает, если не знает ответа?
- Какие данные уходят внешнему провайдеру и сколько хранятся?
- Что оплачивается каждый месяц: токены, GPU, серверы, мониторинг, поддержка?
- Можно ли заменить провайдера и забрать промпты, код, индексы, адаптеры и eval-набор?
- Сколько стоит следующий эксперимент, если первый не пройдёт приёмку?
- Кто отвечает за систему после релиза?
Красный флаг — обещание точности без тестового набора. Второй — обучение до проверки промптом и RAG. Третий — одна круглая цена, в которой отсутствуют данные, безопасность и эксплуатация.
Как оценить окупаемость
Сама нейросеть не является выгодой. Выгода — изменение измеримого процесса.
Годовой эффект = (время до запуска − время после запуска)
                 × число операций
                 × стоимость часа
                 + предотвращённые потери

ROI = (годовой эффект − годовой TCO) / годовой TCO × 100%
Предположим, система освобождает 6 минут на 5000 операций в месяц. Это 500 часов. При внутренней стоимости 1000 ₽/час потенциальный эффект — 500 тыс. ₽ в месяц. Но если половина времени уходит на обязательную проверку, считать нужно 250 часов, а не рекламные 500.
Сначала посчитайте без нейросети. Если вы не знаете текущую стоимость операции и долю ошибок, после запуска будет невозможно доказать экономию.
Для коммерческой оценки можно сопоставить проект с ориентирами стоимости внедрения ИИ-агентов. Там следующий шаг — обсуждение конкретной задачи и состава работ, а не покупка абстрактного «AI».
Частые вопросы
Сколько стоит создать нейросеть самому?
Прототип на готовом API можно собрать почти без инфраструктурных затрат, если у вас уже есть навыки разработки. Но «самому» не делает часы бесплатными: посчитайте анализ процесса, интеграцию, тестирование, безопасность и поддержку. В нашей смете API-MVP занимает 120–212 часов.
Сколько стоит обучить нейросеть на своих данных?
Если данные — это документы и актуальные факты, чаще нужен RAG за 700 тыс.–1,44 млн ₽ по нашей условной ставке. Если требуется изменить поведение модели, проект с дообучением открытой модели ориентировочно стоит 1,5–3,5 млн ₽ с несколькими вычислительными экспериментами. Подставьте собственную ставку и инфраструктуру.
Можно ли создать нейросеть без программирования?
Можно собрать демонстрацию в no-code-сервисе или конструкторе. Для рабочего B2B-процесса всё равно придётся решить авторизацию, права, качество данных, логи, интеграции и ответственность за ошибки. No-code уменьшает часть разработки, но не отменяет архитектуру.
Что дешевле: API или локальная модель?
При небольшой и непредсказуемой нагрузке API обычно дешевле и быстрее для старта. Локальная модель становится интереснее при требованиях к контуру, постоянной высокой нагрузке или необходимости контроля версии. Сравнивайте годовой TCO, а не цену одного запроса.
Когда действительно нужно дообучение?
Когда базовая модель систематически не проходит измеримый критерий поведения, промпт и RAG уже проверены, а у вас есть качественные примеры. Дообучение не должно быть первым шагом только потому, что компания хочет «свою» модель.
Сколько стоит обучить аналог ChatGPT с нуля?
Открытые данные Llama 3.1 показывают масштаб: условный эквивалент аренды H100 для 8B-модели по текущему тарифу AWS — около 656 млн ₽, для 405B — около 13,86 млрд ₽. Это только грубый вычислительный эквивалент без данных, команды и эксплуатации, а не оценка самого ChatGPT.
Как часто пересматривать смету?
Тарифы API и GPU проверяйте перед договором и минимум раз в квартал. Качество и нагрузку — ежемесячно после запуска. Факты и цены этой статьи проверены 5 сентября 2026 года; следующая плановая проверка — 5 января 2027 года.
Вердикт: покупайте проверяемый результат, а не слово «обучение»
Если вам предлагают создать нейросеть, попросите показать строку архитектуры. Готовый API, RAG, дообучение и обучение с нуля — четыре разных проекта.
Для большинства компаний правильная лестница выглядит так: ручной прототип → API → RAG → дообучение. На каждой ступени система должна пройти один и тот же закрытый набор проверок. Если более дешёвая ступень решает задачу, подниматься выше незачем.
Не экономьте на данных и оценке качества ради дорогой модели. Это как купить мощный станок и подавать в него кривые заготовки: шум будет впечатляющим, результат — нет.
Хотите оценить внедрение ИИ для своей задачи? Опишите текущий процесс, объём работы и сервисы, с которыми нужно связать решение. На странице внедрения ИИ-агентов в бизнес — этапы работы и переход к обсуждению задачи. Ориентиры бюджета собраны отдельно на странице стоимости внедрения.
Материал подготовлен от лица Ильи Шведкова. Цены и условия проверены 5 сентября 2026 года.