Почему нам срочно нужна горячая линия по безопасности ИИ
16.09.2024
Раскрой потенциал ИИ с передовыми метриками от DataRobot
17.09.2024Почему нам срочно нужна горячая линия по безопасности ИИ
16.09.2024Раскрой потенциал ИИ с передовыми метриками от DataRobot
17.09.2024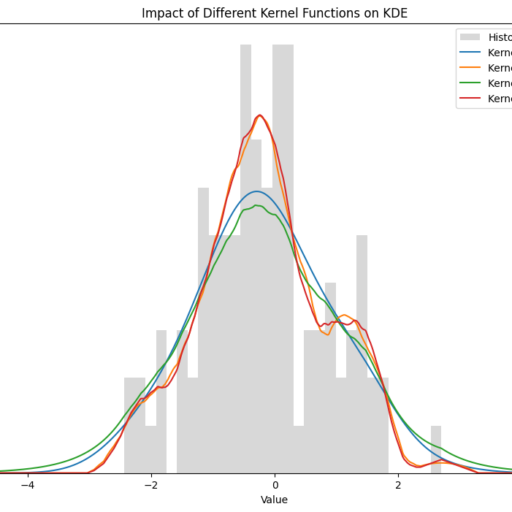
Что такое оценка плотности ядра и почему она важна?
Привет! Давай поговорим о крутом инструменте, который поможет вам лучше разбираться в данных. Вы когда-нибудь задумывались, как можно узнать истинное распределение данных? Гистограммы не всегда справляются с этой задачей. Здесь нам на помощь приходит оценка плотности ядра (ОПЯ). Не бойтесь умных слов — сейчас обо всем расскажу!
Представьте обычную гистограмму…
Вам дали набор данных, и первый шаг в их анализе — это построение гистограммы. Но бывает так, что гистограмма не очень-то помогает понять, как распределены данные на самом деле. Например, вот простая гистограмма:
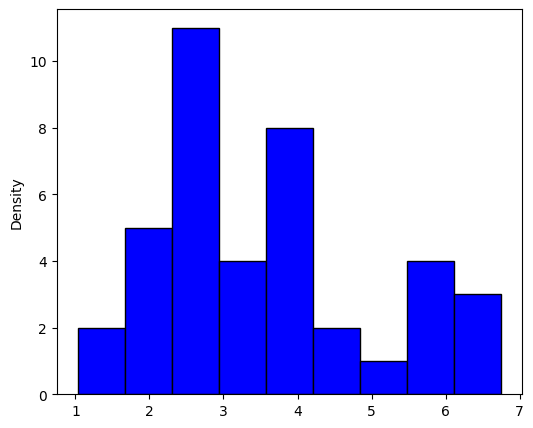
Кажется, ничего не понятно, верно?
Что такое оценка плотности ядра?
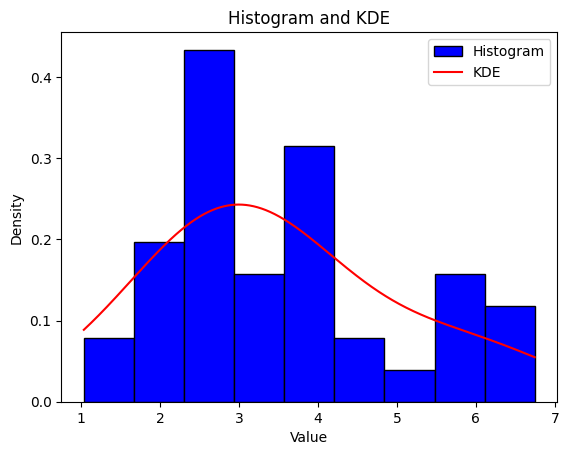
Оценка плотности ядра (ОПЯ) — это метод, который поможет нарисовать более плавную и понятную картину распределения данных. В отличие от гистограмм, не создающих резких прямоугольных форм, ОПЯ позволяет аккуратно обрисовать карту распределения данных. Вот пример как это выглядит:
Почему ОПЯ лучше?
Потому что она более гибкая и дает детальное представление о данных. Оценка плотности ядра работает, вычисляя количество точек данных в пределах определенной ширины (так называемой ширины полосы). Вот код, который это иллюстрирует:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.neighbors import KernelDensity

# Generate sample data
np.random.seed(14)
uniform_data = np.random.uniform(low=1, high=7, size=20)
normal_data = np.random.normal(loc=3, scale=0.7, size=20)

# Combine both distributions
combined_data = np.concatenate([uniform_data, normal_data])

# Compute histogram
hist, bin_edges = np.histogram(combined_data, bins=9, density=True)

# Compute KDE
kde = KernelDensity(kernel='gaussian').fit(combined_data[:, None])
x = np.linspace(min(combined_data), max(combined_data), 1000)[:, None]
log_density = kde.score_samples(x)
density = np.exp(log_density)

# Plot histogram
plt.hist(combined_data, bins=9, density=True, color='blue', edgecolor='black', label='Histogram')

# Plot KDE
plt.plot(x, density, color='red', label='KDE')

# Add labels and legend
plt.ylabel('Density')
plt.title('Histogram and KDE')
plt.legend()

# Show plot
plt.show()
Как выбрать правильные параметры?
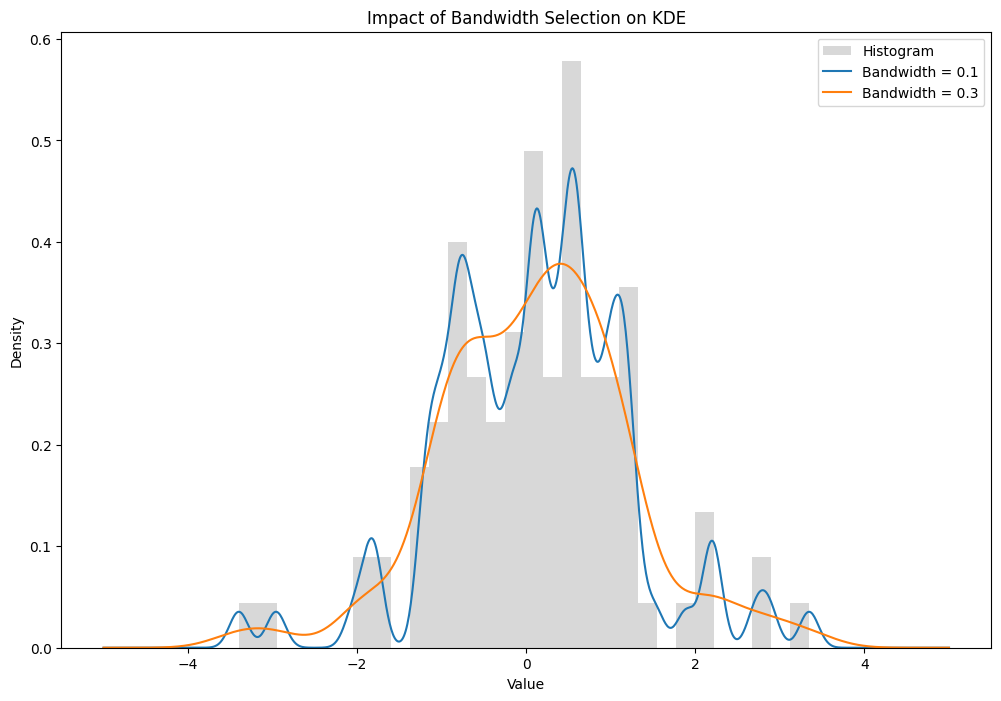
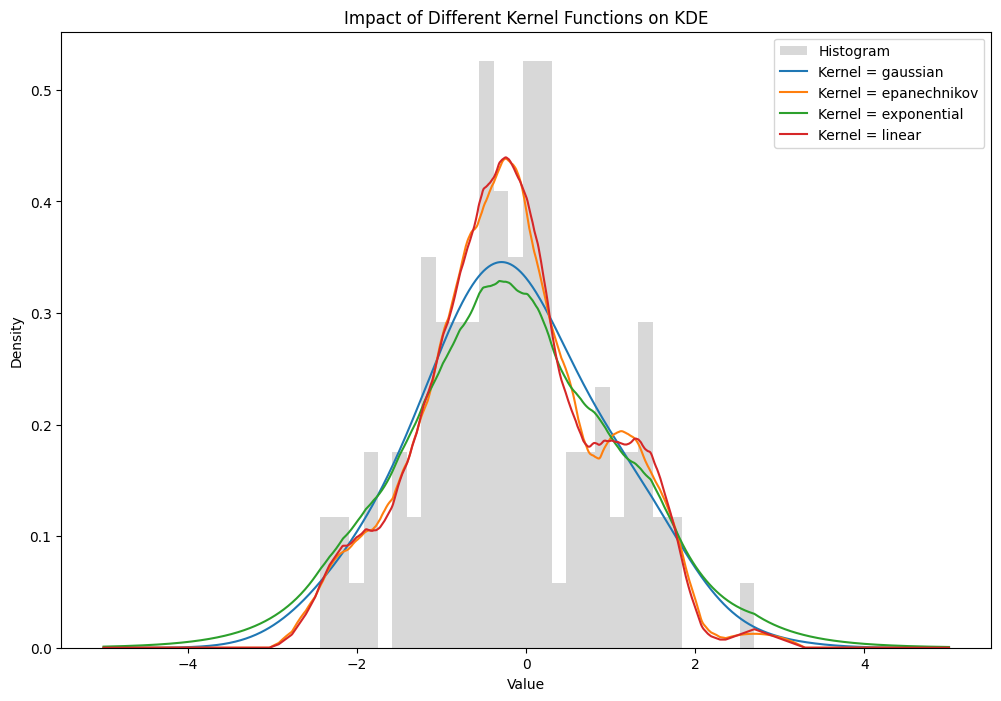
Выбор ширины полосы (или «полоса сглаживания») и формы ядра (основания ядра) очень важен для получения правильного результата. Но не волнуйтесь, основные параметры это ширина полосы и тип использованного ядра.
Зачем это нужно?
ОПЯ незаменима в анализе данных, особенно если вы работаете с данными, которые сложно описать гистограммой. Этот метод используется в разных областях — от машинного обучения до моделирования землетрясений!
Итак, планируете ли вы начать использовать оценку плотности ядра в своих проектах? Не стесняйтесь задавать вопросы!
Понравилась статья? Поделитесь ею с друзьями или оставьте комментарий ниже. Давайте обсудим!