Искусственный Интеллект ВЗРЫВАЕТСЯ: Обзор #293
01.11.2024Вы обязательно должны научиться кодить в ближайшее десятилетие!
02.11.2024Искусственный Интеллект ВЗРЫВАЕТСЯ: Обзор #293
01.11.2024Вы обязательно должны научиться кодить в ближайшее десятилетие!
02.11.2024Как использовать готовые модели в своих проектах?
Приветствую тебя! Недавно я окунулся в мир предобученных моделей из библиотеки Hugging Face и хочу рассказать, как легко можно применять их в работе без стресса.
Как разобраться с текстами
Твоя задача — понять, о чем говорит текст, например, письма или комментарии, и отнести его к нужной категории. Для этого я использую разные методы — от простейших до более сложных с нейронными сетями. Совместное использование этих инструментов помогает получать лучшие результаты.
С чего начать?
- Попроси модель классифицировать текст без обучения (это называется «zero-shot классификация»).
- Используй модели для поиска ключевых понятий в тексте.
- Сначала попроси модель сделать краткое резюме текста, потом классифицируй его.
Где найти подходящие модели?
Иди на Hugging Face и выбирай! Мой совет — обрати внимание на популярность модели и отзывы. Всегда читай документацию — это экономит время.
Как внедрить модель в код?
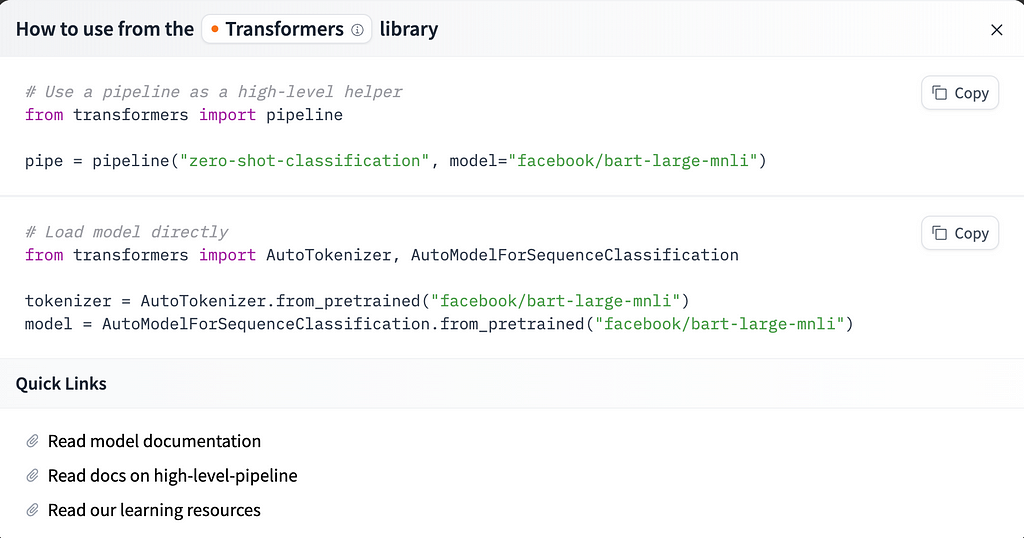
Нашел модель? Отлично! Просто нажми «Use this Model» и следуй инструкциям. Нужно немного кода и готово — у тебя есть работающая модель.
Чуть глубже в детали
Если ты ищешь данные, то можно заглянуть на сайты вроде Kaggle, где много открытых наборов данных. Загрузи данные, модель и токенайзер, следуй инструкциям, и запускай.
Пример: zero-shot классификация
Попробуй классически классировать текст без предварительной подготовки модели. Это ее сильная сторона — она может распознать категории, не будучи специально обученной на них.
«`python
from transformers import AutoModelForSequenceClassification
from transformers import AutoTokenizer
from transformers import pipeline
nli_model = AutoModelForSequenceClassification.from_pretrained(«facebook/bart-large-mnli», model_max_length=512)
tokenizer = AutoTokenizer.from_pretrained(«facebook/bart-large-mnli»)
classifier = pipeline(«zero-shot-classification», device=»cpu», model=nli_model, tokenizer=tokenizer)
label_list = [‘News’, ‘Science’, ‘Art’]
all_results = []
for text in list_of_texts:
prob = classifier(text, label_list, multi_label=True, use_fast=True)
results_dict = {x: y for x, y in zip(prob[«labels»], prob[«scores»])}
all_results.append(results_dict)
«`
Этот код поможет тебе увидеть вероятности для каждой категории и выбрать наиболее подходящую.
Что дальше?
Готов к новым открытиям? Попробуй сам, добавь свои идеи и найди оптимальное решение для своих задач. Делись достижениями и вопросами в комментариях!
Спасибо за внимание! Хочешь узнать больше? Загляни в другие мои работы на www.stephaniekirmer.com.
Полезные ссылки
- Модели на Hugging Face
- Параллельное вычисление моделей
- Open Datasets and Machine Learning Projects | Kaggle